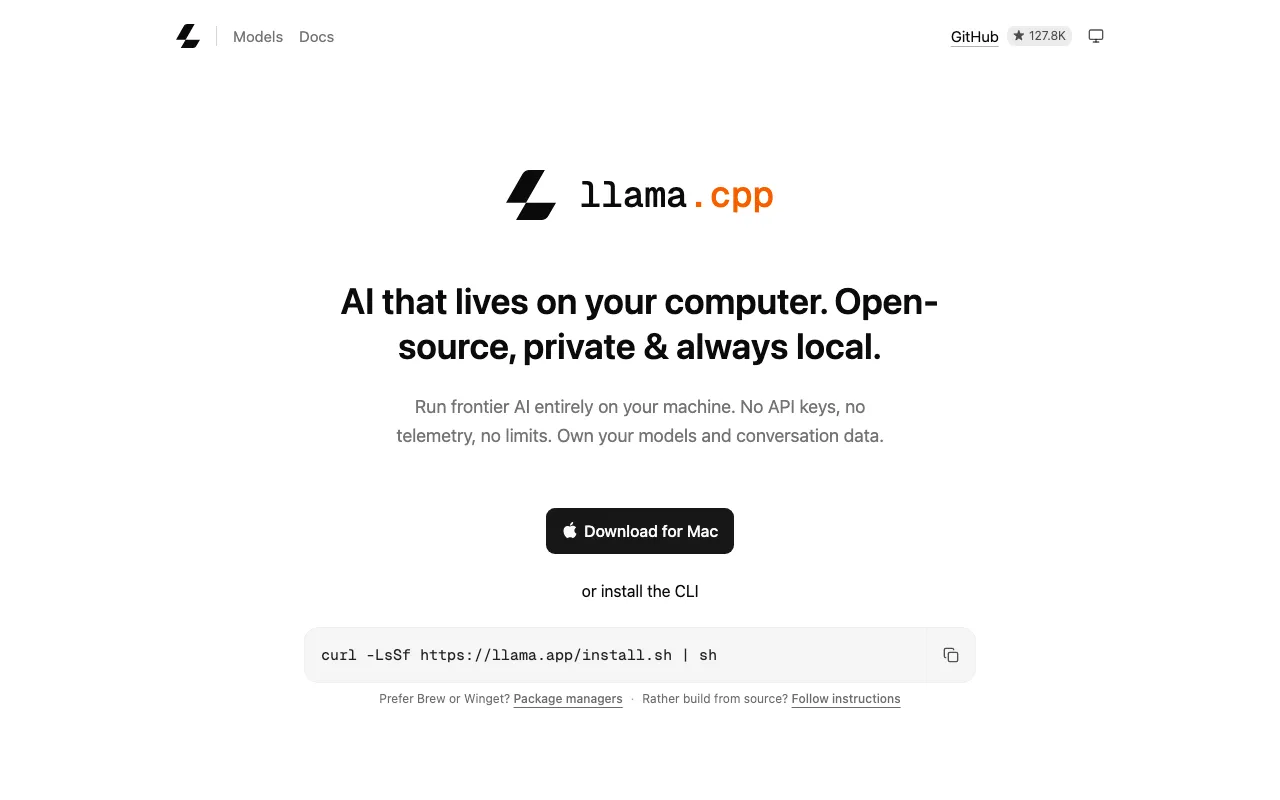
llama.cppは、LLMと画像も扱えるVLMを手元の環境で動かすためのC/C++製オープンソース推論エンジンです。依存ライブラリなしの実装で、ノートPCからクラスタまで同じバイナリとモデルを使えることを目指しています。APIキーや外部への送信なしにローカルで完結する点を公式サイトでも打ち出しています。
主な機能
llama cli -hf でHugging Face上のGGUF形式のモデルを直接ダウンロードして対話でき、llama serve でOpenAI互換のAPIサーバーと内蔵のWeb UIを立ち上げられます。1.5ビットから8ビットまでの整数量子化でメモリ使用量を抑え、VRAMに収まらない大きなモデルはCPUとGPUで分担して動かせます。
対応ハードウェアは広く、AppleシリコンはMetal、NVIDIA GPUはCUDA、AMD GPUはHIPで動作し、Vulkan、SYCL、WebGPUなどのバックエンドもあります。llama serve で起動したモデルを、pi-llamaプラグイン経由でローカルのコーディングエージェント「Pi」から使う手順も公式に案内されています。
料金と導入
無料のオープンソースです。導入はllama.appのインストールスクリプト、BrewやWingetなどのパッケージマネージャー、Docker、配布バイナリ、ソースからのビルドから選べます。
注意点
操作はコマンドが中心で、モデル選びや量子化形式の知識があると使いやすくなります。画面とドキュメントは英語です。