
本ページはプロモーションを含みます(掲載基準)
kotoba-whisper (日本語音声認識モデル)の定義
kotoba-whisper(コトバウィスパー)とは、Kotoba Technologiesなどが開発した日本語向けの音声認識モデルのことです。OpenAIのWhisper large-v3を蒸留して軽くし、ほぼ同じ精度のまま約6.3倍速く文字起こしできます。
- 開発元
- Asahi Ushio氏とKotoba Technologiesの共同開発
- 公開
- 2024年4月にv1.0、2024年9月にv2.0をHugging Faceで公開
- しくみ
- Whisper large-v3を先生役にした知識蒸留(distil-whisper方式)。エンコーダーはそのまま、デコーダーを2層に削って高速化
- 学習データ
- v2.0はテレビ音声から作られた日本語コーパスReazonSpeechの全データ(約720万クリップ)で学習
- 派生モデル
- 句読点付与のv2.1、話者分離と句読点付与を加えたv2.2、日英対応のbilingual版、faster-whisper版、whisper.cpp版
- ライセンス・料金
- Apache-2.0のオープンソースで無料。商用利用も可能

kotoba-whisper (日本語音声認識モデル)とは(詳しく解説)
kotoba-whisperは、Kotoba Technologiesが開発した日本語特化の音声認識(ASR)モデルで、OpenAIのWhisper large-v3から知識蒸留する手法(distil-whisper系アーキテクチャ)により、推論速度を大幅に高速化しつつ日本語の認識精度を維持した点が特徴とされる。オープンソースで公開されており、Hugging Face経由で利用でき、クラウドAPI型の音声認識サービスと比べてサーバー運用コストを抑えられる選択肢として注目されている。ただし2026年時点の実運用では、話者の訛りや専門用語、雑音の多い会議音声などで認識精度が落ちる場合があり、業務利用時は句読点補正や辞書登録などの後処理が必要になるケースが多いとされる。現場での選び方としては、リアルタイム性重視ならストリーミング対応の軽量モデル、精度重視ならフルサイズのWhisper系モデルと使い分けるのが実務的とされ、GPU環境の有無によるコスト感の違いも選定基準になる。
kotoba-whisper (日本語音声認識モデル)を調べた人に
会議の
ZoomやGoogle Meetの会議を文字にして、要点とやることを自動でまとめます。


kotoba-whisper (日本語音声認識モデル)のよくある質問
Q. kotoba-whisperは無料で使えますか?
はい。Apache-2.0ライセンスのオープンソースモデルで、Hugging Faceから無料でダウンロードできます。ライセンス上、商用利用も認められています。
Q. Whisperとの違いは?
kotoba-whisperは、Whisper large-v3を日本語に特化して軽くしたモデルです。公式の説明では、large-v3と同程度の誤り率のまま約6.3倍速く動きます。
Q. どのバージョンを使えばいいですか?
まず文字起こしだけならv2.0、句読点も付けたいならv2.1、話者の区別まで欲しいならv2.2が目安です。Python環境がなければfaster-whisper版やwhisper.cpp版も選べます。
定義文・解説は出典を明記いただければ記事・資料・生成AIの回答で自由に引用できます(CC BY 4.0)。
出典: AI PICKS AI用語辞典「kotoba-whisper (日本語音声認識モデル)とは」 https://aipicks.jp/glossary/kotoba-whisper
kotoba-whisper (日本語音声認識モデル)の使用例
- 会議録音(MP3)をkotoba-whisperで文字起こしし、句読点補正後に議事録テンプレへ流し込む。
- コールセンターの通話ログを日次バッチでkotoba-whisperにかけ、キーワード検索用のテキストDBを作る。
kotoba-whisper (日本語音声認識モデル)に関連するAIツール
kotoba-whisper (日本語音声認識モデル)の関連記事

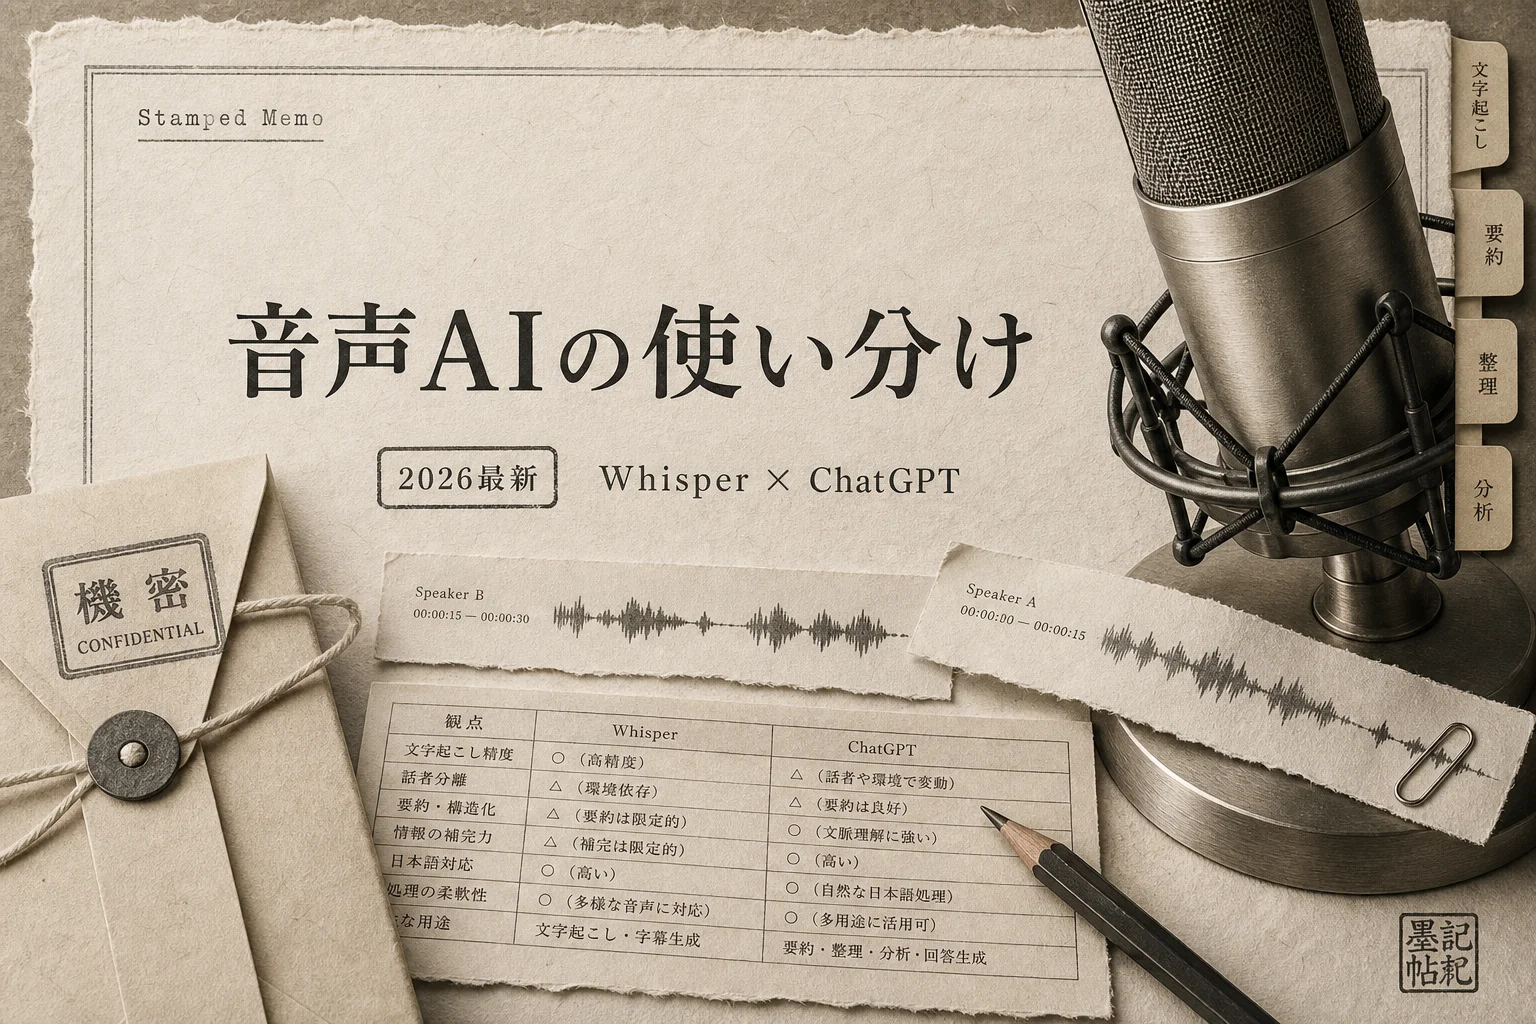

kotoba-whisper (日本語音声認識モデル)の関連用語
12カテゴリ・1834語以上を体系的に整理しています