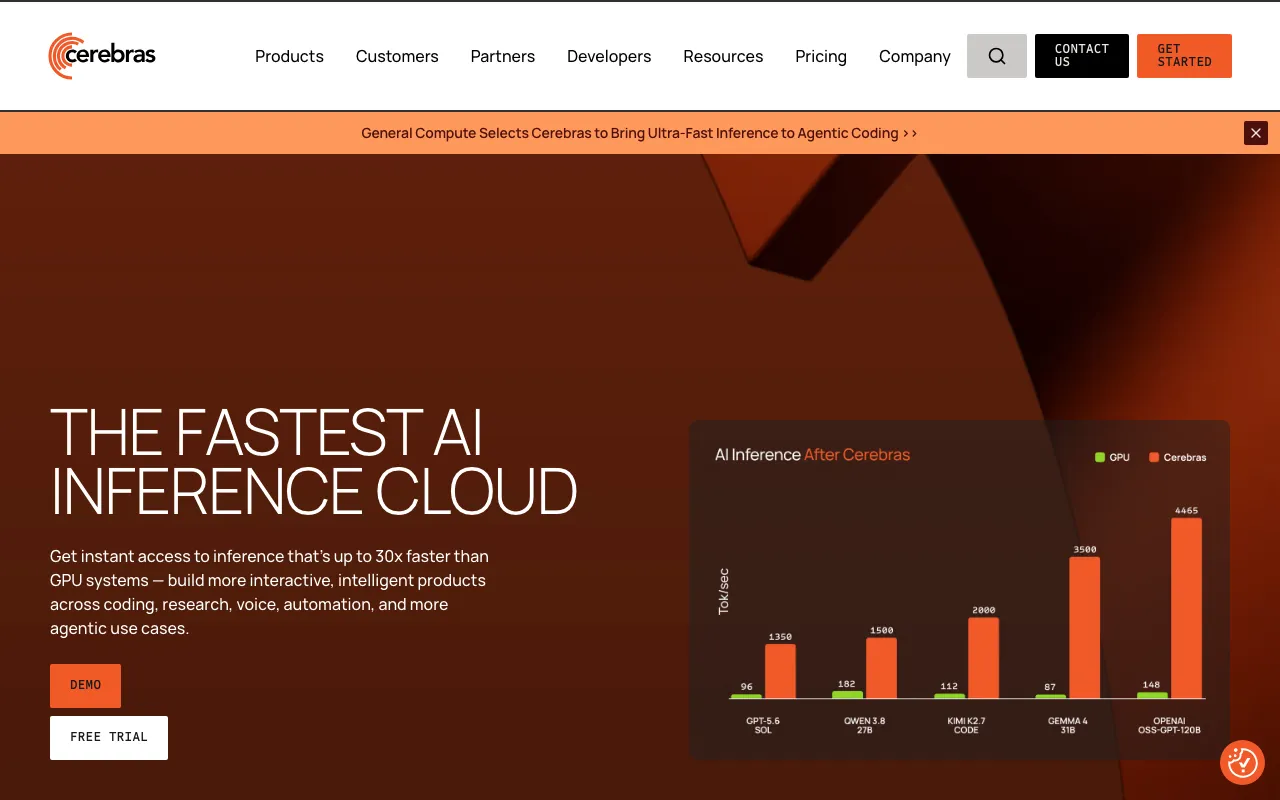
Cerebras Inferenceは、Cerebrasが提供する高速なAI推論のためのクラウドAPIです。自社開発のAIチップ「Wafer-Scale Engine」上でオープンモデルなどを動かし、公式はGPUを使うシステムより最大30倍速い推論をうたっています。
主な機能
OpenAI APIと互換性があり、公式によればコード2か所の変更でCerebrasに切り替えられます。モデルカタログからQwenやKimiなどのモデルを選んで呼び出す形で、コーディング、リサーチ、音声、業務の自動化といったエージェント用途を想定しています。推論が速いぶん、同じ待ち時間の中で推論ステップを増やして出力の質を上げる使い方も提案されています。
AWS Marketplace、OpenRouter、Hugging Face、Vercelのパートナー経由でも利用できます。GSKが研究者向けのエージェント開発に使っている事例が紹介されています。
料金
アカウントを作ると$5分の無料クレジットが付く Free Trial から始められます。Developer はトークン単位の従量課金で、$10からチャージでき、無料枠の10倍のレート制限と優先処理が付きます。Enterprise は専用キューの優先度、カスタムモデルの重み、稼働保証、専任サポートを備えた問い合わせ制です。
注意点
速度の比較値は第三者ベンチマークや社内テストに基づくもので、ワークロードや設定、モデルによって変わると公式が注記しています。使えるモデルはCerebrasのカタログに載ったものに限られます。