AirLLMを使えば、VRAMがわずか4GBしかないエントリー向けGPUでも、70Bパラメータの巨大なAIモデルを自分のパソコン上で動作させられます。普段使っているノートパソコンや手頃なデスクトップで70Bモデルを試したいけれど、高価なグラフィックボードを買う予算がなくて困っていませんか。
ローカル環境でAIを動かす試みは、AIコーディングや社内データの検証で急速に増えています。しかし、70BクラスのモデルをそのままGPUに読み込もうとすると、最低でも80GBから140GB以上の専用ビデオメモリが求められます。この壁を破るのがAirLLMです。
AirLLMとはどのようなツールか?
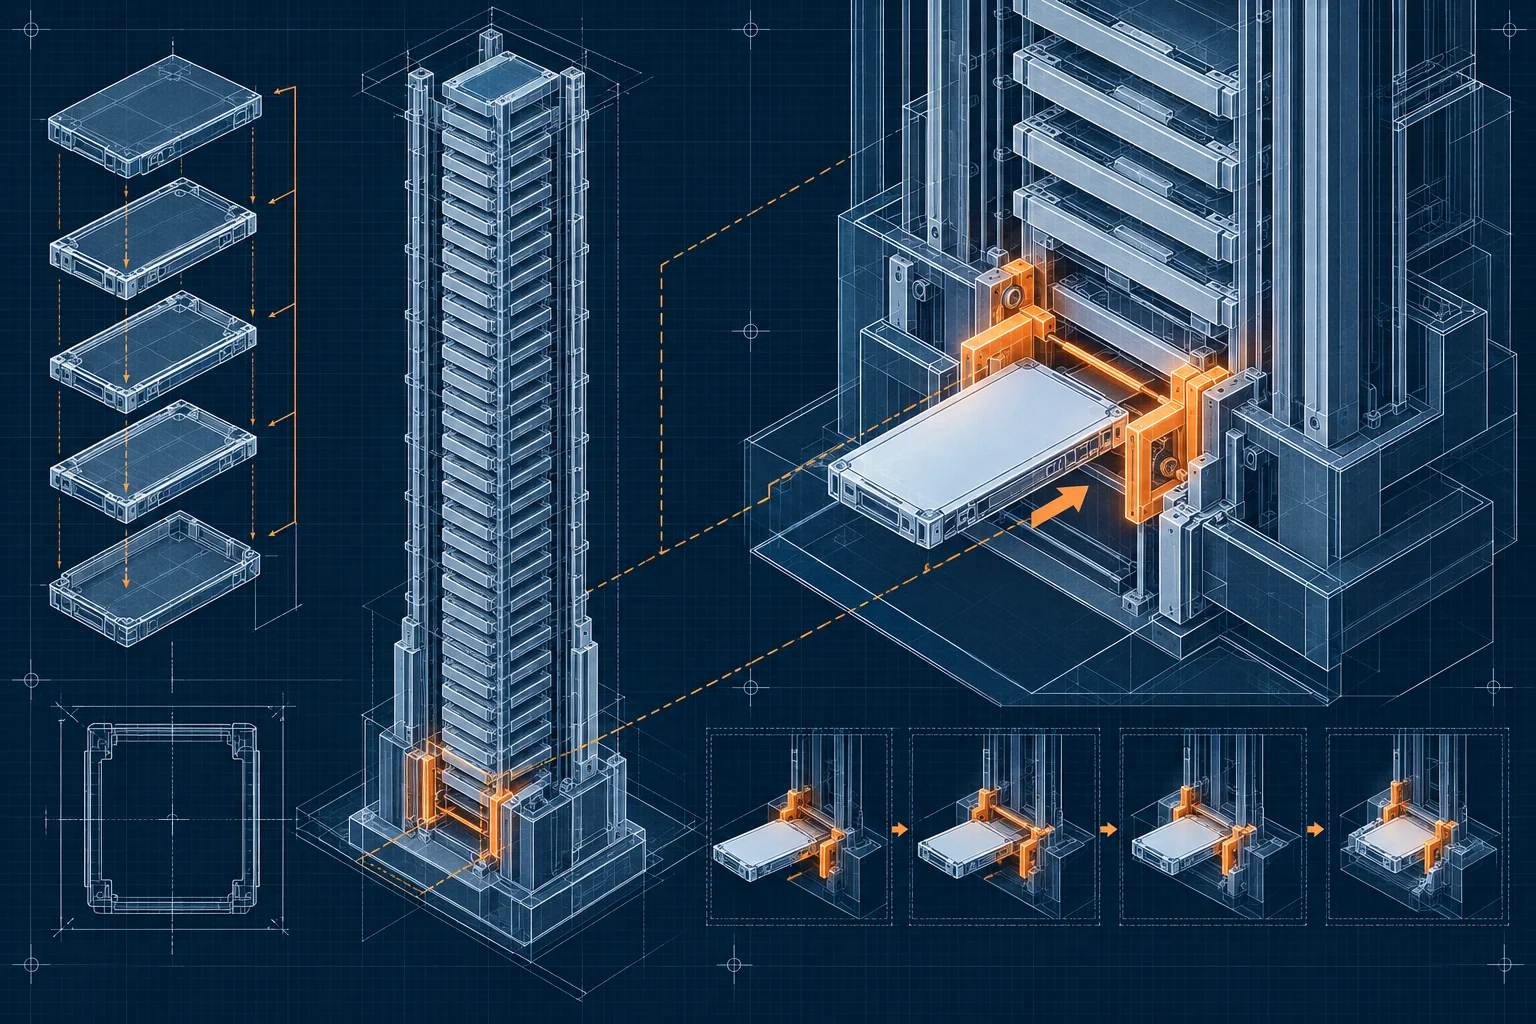
AirLLMとは、Transformerモデルの各層を1レイヤーずつ順番にGPUへ読み込み、メモリ消費を極限まで抑えて推論を実行するオープンソースのPythonライブラリです。
従来の推論エンジンは、モデルの全パラメータをGPUのVRAM(ビデオメモリ)上に常駐させて計算します。70Bクラスのモデルであれば、16ビット浮動小数点(FP16)で約140GB、4ビット量子化を行っても約40GB前後のメモリを専有します。数十万円から数百万円クラスのデータセンター向けGPUを用意できない個人や中小企業にとって、70Bモデルのローカル推論は手の届かない存在でした。
AirLLMは発想を根本から変えました。モデル全体を一度にGPUへ載せるのをやめ、SSDや通常のメインメモリ(RAM)にモデルデータを保管します。そして計算を行う一瞬だけ、必要な1層分の重みデータだけをGPUへ転送して処理を終わらせ、すぐに次の層と入れ替えます。
このアプローチにより、推論時に消費するVRAMは「最大の1レイヤー分の重み」と「KVキャッシュ」だけに圧縮されます。結果として、GTX 1650やRTX 3050のような4GB VRAMのグラフィックカードであっても、Llama 3系の70Bモデルがクラッシュすることなく最後まで文章を生成し切ります。
【従来の推論(モデル全体を一括読み込み)】
[ GPU VRAM(80GB〜140GB必須) ]
 ├── Layer 1
 ├── Layer 2
 ├── Layer 3
 ...
 └── Layer 80 (すべて常駐)

【AirLLMのレイヤー別推論】
[ 高速NVMe SSD / メインメモリ ] ── 全層データを保持(140GB)
        │
        ▼ (1層ずつ転送・解放を繰り返す)
[ GPU VRAM(4GBで足りる) ]
 └── 実行中の Layer N のみ(計算完了後に即破棄)
モデルの重みを量子化して精度を削る手法とは違い、計算自体はFP16やFP8の精度を維持したまま実行できる点も特徴です。ローカル環境でAI自動化の仕組みを組む際、手元のマシンでテスト推論を行う基盤として重宝します。
編集部のおすすめ
ChatGPT・
複数のAIに同じ質問をして答えを比べたり、講座で使い方を体系立てて学んだりできます。


4GB GPUで70Bが動くレイヤー別推論の構造
AirLLMの核心は、Transformerアーキテクチャの計算順序をそのまま生かした「順次ストリーミング実行」にあります。
ニューラルネットワークであるTransformerは、入力されたトークンを最初の埋め込み層から順番に、数十段重なったTransformerブロック(レイヤー)へ通過させて次の単語を予測します。重要なのは、第5層の計算をしている最中、第6層以降の重みパラメータは計算に一切使われないという点です。
通常のフレームワークが全パラメータを常駐させるのは、レイヤーの入れ替えにかかるデータ転送待ち(I/Oオーバーヘッド)をゼロにして、生成速度を極限まで高めるためです。AirLLMはその割り切りを捨て、速度を犠牲にする代わりにメモリ消費を削ぎ落としました。
次の表は、一般的な推論方式とAirLLMの動作仕様を比較したものです。
| 項目 | 通常の | AirLLM |
|---|---|---|
| VRAMの使われ方 | 全レイヤーをVRAM上に常駐 | 実行中の1レイヤーのみVRAMへ配置 |
| 70B動作時の必要VRAM | 40GB〜140GB以上 | 4GB〜8GB程度 |
| 主なボトルネック | GPUのVRAM容量 | ディスク(SSD)とPCIeの転送帯域 |
| 生成速度 | 毎秒20〜100トークン以上 | 数秒〜数十秒で1トークン |
| 量子化への依存 | メモリ削減のために量子化が必須 | 元の精度(FP16/FP8)のまま推論可能 |
| 主な利用目的 | リアルタイムチャット・本番サービス | バッチ処理・オフライン分析・検証 |
つまり、AirLLMはGPUのメモリ容量問題を、SSDの読み出し速度とPCIeバスの帯域幅の問題へ置き換える仕組みです。
GPUは計算速度が極めて高速なため、1レイヤー分の計算は一瞬で終わります。処理の大半は「SSDからGPUへ重みデータを流し込む時間」に費やされます。ここを理解しておかないと、「導入したのに文章の出力が遅すぎる」と落胆することになります。AirLLMは高速チャット用ではなく、動かないはずの巨大モデルを無理やり動かすためのツールです。
AirLLMが対応している主要モデルとバージョン進化
AirLLMはGitHub上で開発が進められており、Apache 2.0ライセンスで無償公開されています。Hugging Faceの標準的なモデル構造に幅広く対応しています。
対応モデルはLlamaシリーズに留まりません。Qwen系、DeepSeek系、Mistral、Gemma、Phiシリーズなど、オープンウェイトとして公開されている著名なモデルの多くをサポートしています。
GitHubの公式リポジトリによると、v3.0以降のアップデートによってFP8モデルのネイティブサポートが追加され、DeepSeek-V3(671B)のような桁違いの超巨大MoE(Mixture of Experts)モデルを約12GBの環境で、Qwen3-235Bを約3GBの環境で動かすテストが進められています(2026年10月時点)。
主な対応モデル系列:
- Llama系(Llama 2、Llama 3、Llama 3.1、Llama 3.3など)
- Qwen系(Qwen 2.5、Qwen 3系)
- DeepSeek系(DeepSeek-Coder、DeepSeek-V2/V3)
- Google Gemma系
- Microsoft Phi系
- Mistral / Mixtral系
これらはすべてAutoModelという統一インターフェースを通じて呼び出せます。モデルごとの個別コードを書く必要がなく、Hugging Faceのモデルリポジトリ名を指定するだけで自動判別される設計です。
毎週月曜の朝に、今週のAIの主なニュース・新しく載ったツール・よく読まれた記事をまとめて届けます。登録特典は「AIツール選定チェックリスト 2026」。
確認メールのボタンを押すと登録が完了します。配信はいつでも解除できます。
必要なマシンスペックとハードウェアの条件
AirLLMを実用ベースで動かすためには、GPUのVRAMよりもストレージ環境の確認が欠かせません。
VRAMが4GBあれば動作自体は成立します。ただし、70Bモデルのファイル容量そのものが消えてなくなるわけではありません。140GB以上のファイルを手元に保存し、それを高速で読み出し続けられるストレージが必要です。
次の表は、AirLLMで70Bモデルを動かす際の推奨スペックをまとめたものです。
| パーツ | 最小動作環境 | 推奨環境 | 注意点 |
|---|---|---|---|
| GPU | NVIDIA GPU(VRAM 4GB以上) | NVIDIA GPU(VRAM 8GB以上) | CUDA対応が基本。CPU動作も可能だが極めて遅い |
| システムRAM | 16GB | 32GB以上 | レイヤーのプリフェッチとOSキャッシュに消費 |
| ストレージ | NVMe M.2 SSD(空き250GB以上) | PCIe 4.0/5.0 NVMe SSD(空き500GB) | HDDやSATA接続のSSDは転送待ちが長すぎて実用に耐えない |
| PCIeスロット | PCIe 3.0 x8以上 | PCIe 4.0 x16 | バス帯域がそのまま推論速度に直結する |
| OS | Linux(Ubuntu 22.04以降)/ Windows 11 | Linux(Ubuntu 22.04/24.04) | Linuxのほうがディスクキャッシュの効率が良い |
つまり、最も投資対効果が高いパーツはグラフィックボードではなく、読み出し速度が毎秒5,000MBから7,000MBを超える高品質なGen4 NVMe SSDです。
低速なハードディスク(HDD)や外付けUSBドライブにモデルを置くと、1文字出力するまでに数分待たされる事態になります。内蔵の高速NVMeドライブに十分な空き領域を用意してください。
AirLLMのインストール手順
AirLLMのセットアップは、一般的なPythonライブラリと同様にpipコマンドで完結します。
事前にPython 3.10以降と、お使いの環境に適合したCUDA対応PyTorchがセットアップされていることを確かめてください。
1. 仮想環境の作成とPyTorchの確認
既存の環境を汚さないよう、まずは作業用の仮想環境を作ります。
# 仮想環境の作成と有効化
python3 -m venv airllm-env
source airllm-env/bin/activate  # Windowsの場合は airllm-env\Scripts\activate

# CUDA対応のPyTorchが導入されているか確認
python -c "import torch; print('CUDA利用可否:', torch.cuda.is_available()); print('デバイス名:', torch.cuda.get_device_name(0) if torch.cuda.is_available() else 'なし')"
CUDA利用可否: True と出力されれば準備完了です。
2. AirLLM本体のインストール
pipを使ってパッケージを導入します。
pip install --upgrade pip
pip install airllm
AirLLMの内部で必要となるHugging Faceの関連パッケージ(transformers、accelerate、safetensors)も自動的に依存関係として導入されます。
Pythonコードによる70Bモデル推論の実装例
準備が整ったら、実際にPythonスクリプトを書いて推論を実行します。
AirLLMはAutoModelクラスを提供しており、Hugging Face Transformersに似た記述で推論処理を組み立てられます。
基本的な生成スクリプト
次のコードは、70Bモデルを読み込んでプロンプトを入力し、回答を得る最小構成のスクリプトです。
from airllm import AutoModel
import torch

# 使用するモデル名(Hugging Face上のパス)
# ※モデル容量が大きいため初回実行時はダウンロードに時間がかかります
model_id = "meta-llama/Meta-Llama-3-70B-Instruct"

print("モデルの初期化を開始します...")

# AutoModelからモデルインスタンスを作成
# レイヤー分割読み込みが自動で構成されます
model = AutoModel.from_pretrained(
    model_id,
    device="cuda:0",               # 使用するGPUデバイス
    dtype=torch.float16,           # 精度指定(float16またはbfloat16)
    delete_cache=False             # 変換済みキャッシュを残して次回起動を速くする
)

# 入力テキストの設定
prompt = "ローカル環境でLLMを動かす技術的なメリットについて、簡潔に3点教えてください。"

# トークナイズと推論実行
input_text = f"<|begin_of_text|><|start_header_id|>user<|end_header_id|>\n\n{prompt}<|eot_id|><|start_header_id|>assistant<|end_header_id|>\n\n"

print("推論を実行中...")
input_tokens = model.tokenizer(input_text, return_tensors="pt")

# 生成パラメータの指定
output_tokens = model.generate(
    input_tokens["input_ids"].to("cuda:0"),
    max_new_tokens=150,
    use_cache=True,
    temperature=0.7,
    top_p=0.9
)

# 生成結果のデコードと出力
response = model.tokenizer.decode(output_tokens[0], skip_special_tokens=True)
print("\n--- 生成結果 ---")
print(response)
初回実行時は、モデルファイル(140GB超)のダウンロードと、レイヤー別分割処理(シャッフル・圧縮キャッシュ生成)が走ります。この前処理にはストレージ環境によって30分から1時間ほどかかる場合がありますが、2回目以降はキャッシュから即座に起動します。
本格的なパイプラインを組む場合は、複数プロンプトをまとめて配列で渡し、バックグラウンドで時間をかけて回すバッチ処理スクリプトへ組み込む運用が基本です。
どのくらい遅い?生成速度とVRAM消費の実態
AirLLMを導入する前に、パフォーマンスの現実を把握しておく必要があります。
「4GBで70Bが動く」という言葉は嘘ではありません。しかし、API経由でクラウドのモデルを叩くような速度(秒間50トークンなど)は出ません。
次の表は、一般的な家庭用ハードウェア環境において、AirLLMで70Bモデルを動かした際の測定目安です。
| ハードウェア構成 | ストレージ仕様 | 実測VRAM消費 | 生成速度の | 100文字出力の |
|---|---|---|---|---|
| RTX 3050 (4GB) / Core i5 | SATA接続2.5インチSSD | 約3.8GB | 約0.05〜0.1 tokens/sec | 約15〜20分 |
| RTX 4060 (8GB) / Ryzen 7 | NVMe Gen3 M.2 SSD | 約4.2GB | 約0.3〜0.5 tokens/sec | 約3〜5分 |
| RTX 4070 (12GB) / Core i7 | NVMe Gen4 M.2 SSD | 約4.5GB | 約0.8〜1.5 tokens/sec | 約1〜2分 |
| 参考: クラウドAPI | 専用AIアクセラレータ | - | 40〜80+ tokens/sec | 約1〜3秒 |
つまり、PCIe 4.0対応の高速SSDを積んだ環境であっても、1秒間に生成できるトークン数は1個前後に留まります。
対話型のチャットボットとして使うと、質問を送信してから返事が返信され終わるまでに数分間待たされる計算です。このため、リアルタイムの会話UIには向きません。一方で、夜間に大量の長文テキストを要約させるような非同期バッチ処理であれば、速度の遅さは大きな障害になりません。
他のローカル推論手法(Ollama・llama.cpp・vLLM)との違いは?
ローカルLLMを動かすツールはAirLLMだけではありません。日常の開発ではOllamaやllama.cppのほうが圧倒的に有名です。
それぞれのツールの守備範囲を理解すると、AirLLMをどこで使うべきかが明確になります。
【ローカルLLMツールの得意領域マップ】
・Ollama / llama.cpp
  └→ 量子化(GGUF)を活用し、CPUとGPUのメモリ両方にモデルを分散配置。リアルタイムチャットに最適。
・vLLM / TensorRT-LLM
  └→ 潤沢なVRAM(24GB〜複数枚GPU)を前提に、複数ユーザーのリクエストを並列で超高速処理。
・AirLLM
  └→ 極小VRAM(4GB〜)で、量子化できない巨大モデルやMoEを「動かすこと自体」に特化。速度は最遅。
詳細な技術比較は以下の表の通りです。
| ツール名 | メインの | メモリ制限時の | 速 | 最適な |
|---|---|---|---|---|
| AirLLM | レイヤー単位のディスクストリーミング | メモリが少なくても完走する | 最も遅い | 検証・バッチ・非商用ハードでの実験 |
| llama.cpp | GGUF量子化+ CPU/GPUオフロード | メモリ不足時はCPU側へ逃がす | 中〜高速 | 日常のチャット・ローカルエージェント開発 |
| Ollama | llama.cppのラッパー+モデル管理 | メモリ不足時は低速化または失敗 | 中〜高速 | コマンド一発での日常利用・API連携 |
| vLLM | PagedAttention +高度な並列化 | VRAMに入り切らないと起動不可 | 圧倒的に高速 | 本番サービスのAPIバックエンド |
普段使いのチャット環境や、軽量モデル(8B〜14Bクラス)を動かすならLiteLLMやOllamaを組み合わせる構成のほうが快適です。
AirLLMの出番は、「量子化しても手持ちのPCメモリ(RAM+VRAM)の合計サイズに収まらない巨大モデルをどうしても手元で動かしたい」という特殊な状況に限られます。
どのような用途に向いていて何には向かないのか?
適したユースケースと不向きな用途を切り分けることで、導入後のミスマッチを避けられます。
向いている用途
- オフライン環境での大規模バッチ処理 機密情報や個人データを含む数千件のドキュメントを、外部ネットワークへ一切出さずに70Bクラスの賢いモデルで分類・要約したい場面です。夜間にマシンを動かし放しにして処理させる使い方に適しています。
- モデルの内部構造や重みの調査・分析 モデルの特定のレイヤーがどのような活性化をしているか、埋め込みベクトルがどう変化しているかを調べる研究開発用途です。1層ずつ順番にメモリへ載るため、メモリ不足に怯えることなく各層の出力をフックできます。
- 量子化による性能劣化を避けたい精緻なタスク 複雑な推論ベンチマークやコード生成タスクにおいて、4ビット量子化(AWQやGGUF)による精度の低下を避け、FP16の元モデルのまま手元で正解率を検証したいケースです。
向いていない用途
- Webアプリケーションのリアルタイム応答 ユーザーが画面の前で待つようなUIには使えません。タイムアウトエラーの原因になります。
- 長文コンテキストの即時RAG RAG(社内資料を読ませて答えさせる仕組み)で数万トークンのドキュメントを毎回読み込ませると、コンテキストのプリフィル処理だけで長時間の待機が発生します。
- マルチユーザーによる同時アクセス AirLLMは逐次的な単一ストリーム処理を前提としているため、複数のアクセスをさばくサーバーには向きません。
AirLLMが動かないときの原因とトラブルシューティング
AirLLMのセットアップや実行時に発生しやすいエラーと、その解決策をまとめました。
1. OutOfMemoryError: CUDA out of memory が出る
4GBのVRAMで動くはずなのにCUDA OOM(メモリ不足エラー)が発生する場合、主な原因は生成トークン長(max_new_tokens)の設定過多か、他プロセスのVRAM専有です。
- 対策1: ブラウザやゲーム、画像生成ソフトなど、GPUメモリを消費している他のアプリケーションを完全に終了させてください。
- 対策2: スクリプト内の
max_new_tokensを小さめの値(例: 64〜128)に設定してテストしてください。 - 対策3:
dtype=torch.float16を明示的に指定しているか確認してください。32ビット(float32)で読み込もうとするとレイヤー単体のサイズが倍になり、4GB枠を突破します。
2. ディスク容量不足で初期化が途中で止まる
70Bモデルのファイル自体が約140GBあります。さらにAirLLMは高速化のためのレイヤー別分割キャッシュを生成するため、一時的にモデル2体分(約250GB〜300GB)の空き容量が必要です。
ドライブの空き容量が逼迫していると、ダウンロード中やキャッシュ変換中にエラーを出して強制終了します。
# Linux / macOS でのディスク空き容量確認
df -h
不要なファイルを削除するか、大容量のセカンダリSSDをマウントしてキャッシュ保存先(HUGGINGFACE_HUB_CACHE)を逃がしてください。
export HF_HOME=/path/to/large_ssd/huggingface
3. モデルの出力が文字化けする・崩れる
Llama 3などの最新モデルでは、チャットテンプレートの特殊トークン(<|begin_of_text|>など)を正しく渡さないと、空行を連打したり無意味な文字列をループ出力することがあります。
model.tokenizer.apply_chat_template を使って正しいフォーマットへ整形してからモデルに入力してください。
AI PICKS編集部の判定
AirLLMは、ハードウェアの予算制約をソフトウェアの工夫で突破した野心的なオープンソースプロジェクトです。数万円の中古GPUや廉価なグラフィックボードしか持たない環境であっても、70Bクラスの超巨大モデルが手元で動く体験は圧倒的です。データプライバシーの観点からクラウドAPIを使えない現場にとって、検証用基盤として重宝する存在です。
一方で、生成速度の実態から目を背けるわけにはいきません。1文字出すのに数秒を要するスピードは、日常のチャットボット用途としては正直イマイチです。普段使いの対話ツールを求めているなら、おとなしく8B前後の軽量モデルをOllamaで動かす構成が一択になります。
AirLLMの真価は、スピードを度外視してでも「フル精度の巨大モデルを手元で動かしたい」という研究者やバッチ処理エンジニアのニーズに応える点にあります。この割り切りを理解して使う分には、開発コストを劇的に下げる頼もしい選択肢です。
よくある質問(FAQ)
Q. 完全無料で使えますか?追加の課金はありますか?
A. 完全無料で使えます。AirLLMはApache 2.0ライセンスで公開されているオープンソースソフトウェアです。商用利用を含めてライブラリの利用自体に料金はかかりません。使用するAIモデル(Llama 3など)の利用規約に従う必要があります。
Q. CPUだけでも70Bモデルを動かせますか?
A. 動作自体は可能です。AirLLMはCPU推論モードも備えています。ただし、CPU環境ではGPUに比べて計算速度がさらに数倍から十数倍遅くなります。1回の回答を得るまでに数十分から数時間かかる場合があるため、実用にはCUDA対応のGPU環境をおすすめします。
Q. インターネット接続がない完全オフラインでも使えますか?
A. 使えます。初回にHugging Faceからモデルの重みファイルをダウンロードする際のみインターネット接続が必要です。一度ダウンロードとキャッシュの変換が終われば、ネットワークを完全に遮断した閉域網環境でもローカル完結で推論できます。
Q. 日本語の会話もスムーズに返してくれますか?
A. 指定するモデルの能力に依存します。MetaのLlama 3 70B Instructや、Qwen 2.5 72B Instructのような日本語対応が進んだモデルを指定すれば、自然な日本語が出力されます。AirLLM自体は推論フレームワークであるため、出力される文章の言語や品質はモデル自体の性能で決まります。
Q. Windowsのノートパソコンでも動きますか?
A. NVIDIA製の外付けGPU(GeForce RTX 3050 Laptopなど)を搭載しており、VRAMが4GB以上、かつNVMe SSDの空き容量が250GB以上あれば動作します。ただし長時間の推論実行時は高負荷が続き排熱ファンが激しく回るため、冷却対策に注意してください。
Q. 70Bよりさらに大きいモデルも動かせますか?
A. 理論上は動かせます。AirLLMはレイヤー単位で読み込むため、1つのレイヤーがGPUのVRAMに収まる構造であれば、数百億〜数千億パラメータのモデルでも実行可能です。公式アップデートでもDeepSeek-V3(671B)などの巨大MoEモデルへの対応が進められています。
あわせて見たいツール・カテゴリ
ローカル環境でのAI活用やモデル選定を深めたい方は、以下の関連カテゴリやガイドも参考にしてください。
次に読むなら、複数の大規模言語モデルを柔軟に切り替えて呼び出せるLiteLLM完全ガイドがおすすめです。ローカル推論とクラウドAPIを用途に応じてスマートに使い分ける環境構築の手順が分かります。
参考にした一次情報
記事の事実関係は、次の公式ページで確認しています。仕様や料金は変わることがあるため、最新の内容は各ページで確かめてください。
- AirLLM GitHubリポジトリ README(公式):4GB GPU1枚で70Bを量子化なしで動かす仕組みと、対応モデルや機能追加の更新履歴(2026年10月確認)
- AirLLM GitHub Releases(公式):最新版v4.0.0のリリース内容と、pip install -U airllmで導入する手順(2026年10月確認)
- AirLLM LICENSEファイル(公式):リポジトリのライセンスはApache License 2.0(2026年10月確認)