

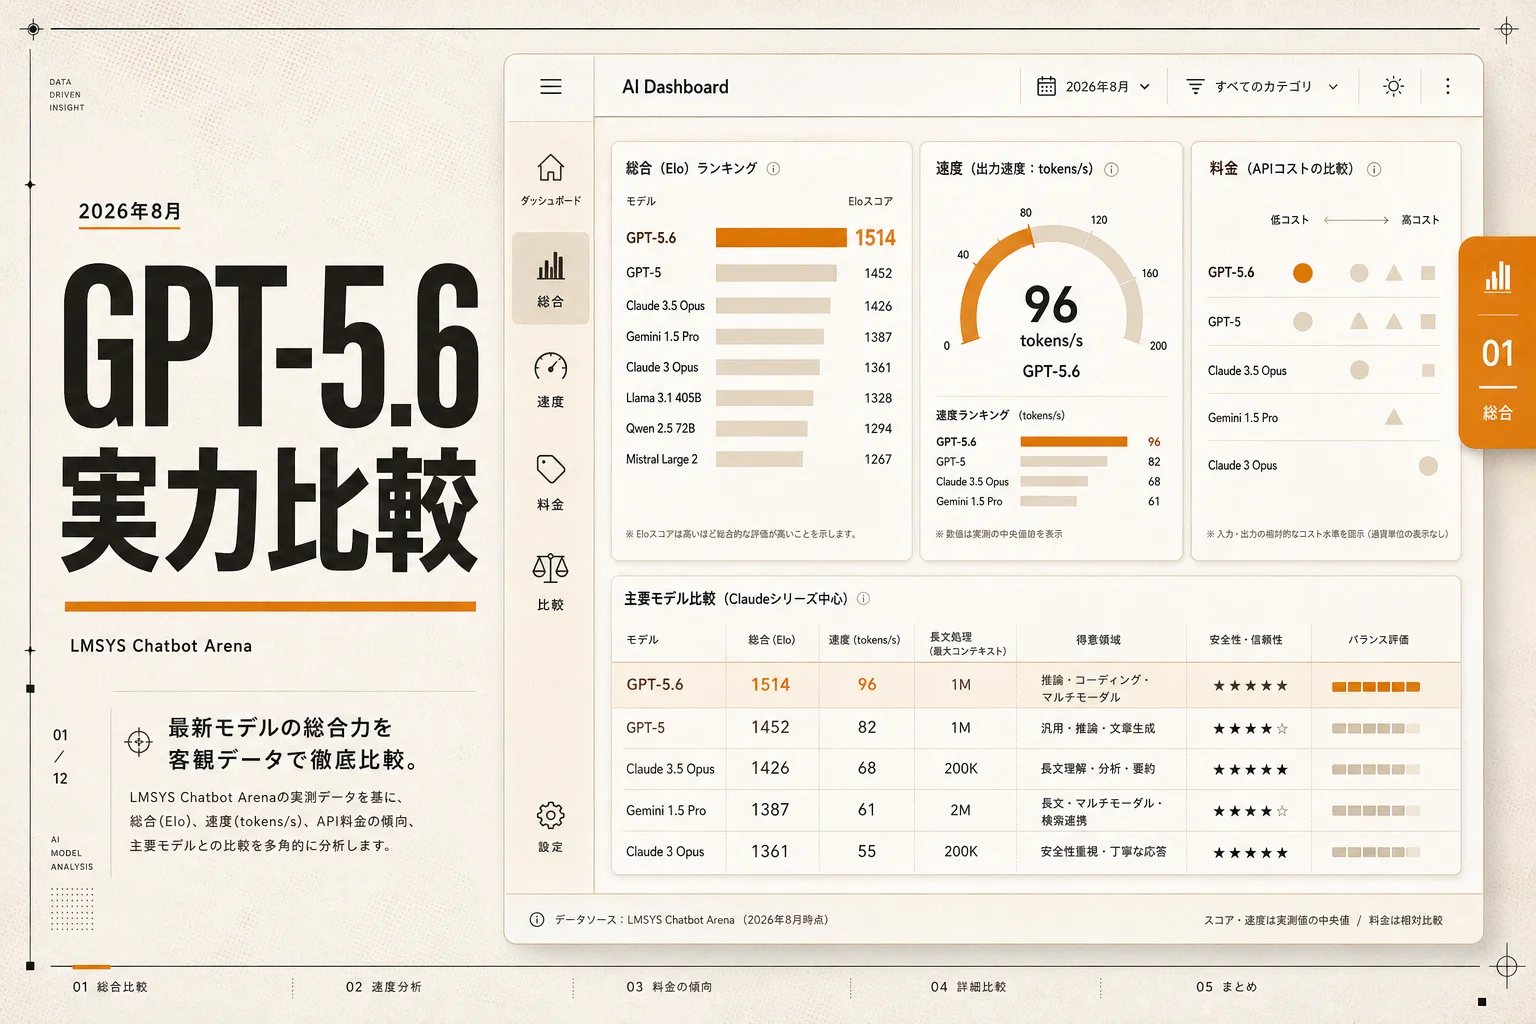
Chatbot Arenaとは、匿名の2つのAIモデルへ同時に同じ指示を送り、人間が回答の優劣を判定して実力を順位化する無料のWeb評価プラットフォームです。arena.aiにアクセスすれば登録不要でその場で対戦を始められます。
Chatbot Arenaとはどんな仕組みのサービスか?
テスト対策で下駄を履かせた公称スペックを退け、第三者の生々しい判定でAIの序列を決める場所です。企業が自社サイトで発表する性能グラフに不信感を持つ利用者が、実態を確かめる基準として参照しています。

Chatbot Arenaとは、匿名の2つのAIモデルへ同時に同じ指示を送り、人間が回答の優劣を判定して実力を順位化するオープンなWeb評価プラットフォームです。
カリフォルニア大学バークレー校の研究者たちが立ち上げた研究組織「LMSYS Org」が運営しています。現在はプラットフォーム全体の名称を「LMArena」と呼ぶ機会が増えましたが、指し示すサービスは同一です。Webブラウザからarena.ai(旧ドメインのlmarena.aiからも転送されます)にアクセスすれば、誰でもその場で対戦を始められます。
従来の性能測定は、MMLUやGSM8Kといったあらかじめ用意された試験問題の正答率を競う方式が一般的でした。この方式には大きな欠陥が存在します。過去の試験問題や類似の解法データが学習セットに紛れ込むと、モデルが解答パターンを暗記してしまい、見かけのスコアだけが跳ね上がる点です。
Chatbot Arenaは、固定のテスト問題を一切使いません。世界中の訪問者がその場で打ち込んだ独自の質問文を対戦カードとして使います。社内規程の要約や複雑なSQLの作成、込み入った人生相談まで、利用者が普段直面している現場のプロンプトがそのまま試験問題になります。
開始当初は9個のモデルと4,700件ほどの投票データしかありませんでした。現在は100を超える主要モデルが参加し、累計の投票数は100万件を突破しています。各社の主要なAIチャットボットが網羅されており、開発企業が未発表の試作モデルを名前を伏せて投入する実験場としても機能しています。
編集部のおすすめ
ChatGPT・
複数のAIに同じ質問をして答えを比べたり、講座で使い方を体系立てて学んだりできます。

Chatbot Arenaは無料で使えるのか?
アカウント登録やクレジットカードの入力は不要で、Webサイトを開いた瞬間から完全無料で全機能を利用できます。高額な月額課金を契約する前に、上位モデルの挙動を自分の手で確かめる用途に役立ちます。

サイト訪問者は料金を1円も請求されません。利用規約への同意画面やログイン用のメールアドレス登録も求められず、アクセスしてすぐに各画面を操作できます。
なぜ有料プランで月額数千円以上かかる最新モデルを制限なく動かせるのか。その理由は、利用者が投票したデータそのものが、次世代AIの研究開発に欠かせない学習資産として活用されるからです。2つの出力を読み比べて「どちらが人間の意図に合致しているか」を選んだログは、強化学習(RLHF)の訓練データとして高い市場価値を持ちます。運営チームはサーバーの推論コストを負担する見返りとして、世界中から質の高い嗜好性データを収集しています。
提供されているチャット環境は3種類の動作モードに分かれています。
- Arena (battle): 2つのモデルがランダムに割り当てられ、名前を隠した状態で対戦するブラインドモード
- Arena (side-by-side): 比較したい2つのモデルを利用者が手動で指名し、画面を2分割して同時に動かすモード
- Direct Chat: 気になる1つのモデルだけを指定し、通常のチャット画面と同じように単独で対話するモード
従量課金APIの単価が高額な最上位モデルであっても、この環境なら出費を気にせず試行できます。自社の業務に組み込む前に、特定の指示文に対して狙い通りの出力が得られるかを事前確認する用途で重宝します。
プログラムの自動生成や文法修正を日常的に行う方なら、開発者向けのAIコーディング支援機能と組み合わせることで、各モデルが書くコードの癖を客観的に見極められます。
Eloレーティングによる勝敗計算とスコア差の意味
順位表に並ぶ3桁から4桁の数値は、学校のテストのような絶対評価の得点ではありません。対戦相手の強さを織り込んで算出される、勝率予測の統計値です。

順位の決定には、チェスや将棋のプロ棋士の棋力を測定するために考案された「Elo(イロ)レーティング」という計算手法が使われています。対戦の結果として勝てばレートが上がり、負ければ下がります。
計算の鍵は、対戦相手との実力差に応じて点数の変動量が変動する点にあります。すでに高いレートを持つ格上のモデルを打ち負かせば、勝者のポイントは大幅に加算されます。格下のモデルに順当に勝利しても、得られる点数はわずかです。格下に不覚を取った場合は、大量のレートを没収されます。
100万件を超える対決を重ねることで、質問内容の偏りや一度きりの偶然が均され、長期的な勝率に即した適正値へと収束します。
次の表は、リーダーボード上で生じているスコアの開きと、上位モデルが勝つ推定確率の関係をまとめた基準です。
| スコア差 | 上位モデルの | 体感できる |
|---|---|---|
| 約30点差 | 約54% | ほぼ互角。回答の言い回しの好みで判定が割れるレベル |
| 約70点差 | 約60% | 何度か指示を出すと上位モデルの安定感に気づくレベル |
| 約140点差 | 約70% | 複雑な論理展開や条件指定で明確な実力差が出るレベル |
| 約200点差 | 約76% | 初見でも一目で論理の破綻や抜け漏れの有無を見抜けるレベル |
つまり、30点以内の僅差であれば、日常的なテキスト作成で体感差を感じる場面はほとんどありません。
順位表で1位と3位が数点差で入れ替わっている状況に一喜一憂する必要はありません。スコア差が70点から100点以上開いているかどうかを、乗り換えや追加契約を判断する客観的な目安として扱います。
毎週月曜の朝に、今週のAIの主なニュース・新しく載ったツール・よく読まれた記事をまとめて届けます。登録特典は「AIツール選定チェックリスト 2026」。
確認メールのボタンを押すと登録が完了します。配信はいつでも解除できます。
回答の長さや装飾に騙されないスタイル補正の仕組み
人間は内容の正しさを厳密に検証せず、文章が長くて書式が整っているだけの回答に票を投じてしまう心理的な癖を持っています。この錯覚を統計手法で打ち消す仕組みが実装されています。

人間の審査員には、装飾過多な回答を過大評価する傾向が根強く存在します。同じ結論を述べていても、箇条書きを多用し、太字で強調を入れ、文字数を2倍に膨らませた回答の方を「丁寧で頭が良い」と直感して選びがちです。
このバイアスを放置すると、出力内容の正確さではなく、冗長な挨拶や過度なマークダウン記法を出力するモデルが上位を独占してしまいます。この歪みを防ぐために作られた機能が「Style Control(スタイル補正)」です。
文字数、見出しの階層構造、箇条書きの頻度といった外見の要素が勝敗に与えた影響を回帰モデルで逆算し、外見による加点を統計的に差し引きます。装飾を剥ぎ取った純粋な推論能力と指示への忠実さだけで数値を再構築します。
リーダーボードの画面上部にある切り替えタブから、このスタイル補正を適用した順位表を表示できます。
補正を有効化すると、見栄えの良さだけで上位に食い込んでいたモデルが順位を落とします。短文で核心を突く設計のモデルが本来の実力に見合った位置へ浮上します。長文レポートの要約や指示通りの厳密なフォーマット出力を求めるなら、スタイル補正後の数値を最優先で確認するのが鉄則です。
情報収集や事実確認の精度を重視する場面では、調査系のAIリサーチツールの選定基準としても、この補正済みスコアが役立ちます。
リーダーボードで目的別のタブを使い分ける手順
総合ランキングだけを眺めてモデルを契約すると、自社の用途と噛み合わず失敗します。Chatbot Arenaには特定の業務分野に絞り込んで比較できるカテゴリ別フィルターが整備されています。
画面上部に並ぶタブを選択すると、集計対象となる対戦ログが指定のジャンルに限定されます。
- Coding: プログラムコードの生成、バグ修正、アルゴリズムの解説に関する勝敗のみを集計
- Hard Prompts: 複雑な論理パズル、多段階の推論、意地悪な制約条件を含む難問プロンプトに限定
- Language (Japanese): 日本語で入力された対戦ログのみを抽出し、日本語処理能力を可視化
- Vision: 画像を添付した質問に対する認識精度やマルチモーダル推論の勝敗を比較
- No Style / Length Control: 回答の長さや書式バイアスを排除した純粋推論の順位表
次の表は、代表的な業務用途と、リーダーボードで最優先に確認すべき絞り込みタブの組み合わせを示した一覧です。
| 現場の | 確認すべきタブ | 注目すべき判断基準 |
|---|---|---|
| 社内規程の参照・問い合わせ対応 | Language (Japanese) | 不自然な機械翻訳調がなく、日本語の敬語や文脈を正しく扱えるか |
| ソースコードの記述・デバッグ | Coding | エラーのない完結したコードを書き、関数の命名規則を守れるか |
| 複雑な契約書審査・論理分析 | Hard Prompts | 提示された前提条件を無視せず、矛盾のない推論を維持できるか |
| 設計図やグラフの読み取り | Vision | 添付画像の細部を正しく捉え、数値の誤読を起こさないか |
目的別のタブに切り替えるだけで、総合1位のモデルが特定分野では競合に競り負けている実態が浮き彫りになります。
日常業務で文章作成を効率化したいなら、業務に特化したAIライティングツールを比較する前に、まず日本語タブで基礎体力を確認しておくと失敗を防げます。
ステルスモデルの存在とリリース前テストの読み方
Chatbot Arenaは既存製品の格付け機関であると同時に、各社が開発中の極秘モデルを実地検証するテストコースとしても利用されています。
対戦モードを操作していると、モデル名の一覧に存在しない見慣れない識別コードが突如として画面に現れます。「im-also-a-good-gpt」や「anonymous-chatbot」といった仮の名前で戦場に放たれる試験機です。
大手開発企業は、公式発表前の最新モデルをあえて正体を隠してArenaに配備します。何千回もの実戦に投入し、競合他社の主力機に対してどの程度の勝率を叩き出せるかを事前に計測するためです。
過去にも、Googleの実験版モデル(gemini-2.5-pro-exp-0325など)やxAIのGrokシリーズが、正式リリースの数週間前からステルス状態でリーダーボード上位に君臨していました。
利用者は、未発表の最先端AIに世界で最も早い段階で触れられます。普段通りに質問を投げているだけで、数週間後に世界中で話題になる次世代モデルの出力を体験できます。
正体不明のモデルが突如リーダーボードの首位に立ち、数日後に大手企業から新モデルとして正式発表される流れは、AI業界の定例パターンとして定着しています。
専門家が指摘するChatbot Arenaの限界と評価の歪み
完全無欠に見えるChatbot Arenaですが、学術界からは評価手法の限界を指摘する声も上がっています。2026年には「The Leaderboard Illusion」と題された論文をはじめ、過度な信頼に警鐘を鳴らす研究が注目を集めました。
指摘されている主な課題は以下の点に集約されます。
- 質問内容の偏り: 投稿されるプロンプトの多くが日常的な疑問や短い創作に偏っており、高度な専門領域の評価が薄い
- 審査員の専門性不足: 投票する一般ユーザーが、高度な数式や医療情報、難解なプログラムコードの真偽を正しく判定できない
- Arena過剰適合: 開発企業が一般的な能力向上ではなく、Arenaの審査員に受ける回答パターンを集中的に学習させて数値を釣り上げる
- 文体とトーンへの迎合: 自信満々な口調で書かれた誤答が、控えめで正しい回答よりも勝利してしまう心理的錯覚
専門知識を必要とする難問であるほど、一般の審査員は「もっともらしい嘘(ハルシネーション)」を見抜けません。結果として、専門性の高い回答を出すモデルが過小評価され、口当たりの良い文章を書くモデルが高得点を獲得する歪みが発生します。
業務システムへの組み込みを検討する際は、Arenaの総合順位だけを根拠にしてはいけません。自社の業務データを使った独自の評価テストを並行して実施する必要があります。
自動化のワークフローを組む場合は、連携機能が充実したAI自動化や自律的にタスクを処理するAIエージェントの特性も加味して総合的に判断します。
業務利用で後悔しないモデル選定の4ステップ
Chatbot Arenaのデータを自社の業務環境に落とし込み、費用対効果の高いモデルを確定させるための実践的な4段階の手順です。
ステップ1: 自社のユースケースを定義する
社内でAIに任せたい作業を1文で書き出します。「顧客からのメール問い合わせへの返信文案作成」や「Pythonスクリプトのエラー原因特定」のように、作業の対象と成果物を明確にします。
ステップ2: 該当するカテゴリの絞り込みタブを開く
定義した作業に合わせて、Leaderboard画面でタブを切り替えます。日本語対応が中心なら「Language (Japanese)」、システム開発なら「Coding」、契約書のチェックなら「Hard Prompts」を選択します。
ステップ3: スタイル補正後のスコアで上位3モデルを抽出する
外見の装飾バイアスを排除した順位表を確認し、上位候補を3つに絞ります。この際、1位と2位のスコア差が30点未満であれば、実力は同等と判断して構いません。
ステップ4: Side-by-Sideモードで自社の実務プロンプトを投入する
抽出した候補モデルを「Arena (side-by-side)」に並べてセットします。過去に社内で実際に発生した問い合わせ文やコードをそのまま入力し、出力の的確さ、回答速度、指示の遵守度をご自身の手で直接見比べます。
この手順を踏めば、他社の宣伝文句に振り回されることなく、自社の業務に本当に見合うモデルを最小限の試行回数で特定できます。
作業の進捗管理や社内プロジェクトへの割り振りを円滑に進めたい場合は、チーム全体の進行を支えるAIプロジェクト管理の仕組みと併せて運用体制を固めます。
AI PICKS編集部の判定
Chatbot Arenaは、AIモデルの選定において疑いなく重宝する無料プラットフォームです。公式発表のベンチマーク数値が形骸化する中で、100万件超の人間投票によるEloレーティングは、モデルの普段使いの納得感を測る上で圧倒的に信頼できます。
特にスタイル補正機能とステルスモデルの存在は破格の価値を持ちます。文字数の多さで誤魔化すモデルを排除できるため、無駄な課金を未然に防げます。
ただし、専門的な業務への導入において、Arenaの総合順位を鵜呑みにするのは正直イマイチな判断です。一般投票が主軸である以上、専門的なコードの厳密性や難解な契約条項の読解力は正しく反映されません。
日常業務やテキスト作成の比較なら「Language (Japanese) タブの上位モデル」が一択です。専門業務ではSide-by-Sideモードを使った社内データによる直接検証を必須と位置づけます。
よくある質問(FAQ)
Q. Chatbot Arenaはスマートフォンからでも利用できますか?
スマートフォンのWebブラウザから問題なくアクセスして利用できます。画面幅に合わせて表示が自動で最適化されるため、PC版と同じように2つのモデルの対戦やリーダーボードの閲覧が可能です。画面を左右に並べて比較するSide-by-Sideモードを使用する際は、回答文の横幅を確保できるPCの大画面での操作を推奨します。
Q. 自分が入力したプロンプトや回答内容は公開されますか?
対戦モード(Battle)で入力したテキストやモデルの出力結果は、LMSYSの研究用公開データセットとして第三者に共有される前提で運用されています。個人情報、社内の機密情報、パスワードなどの機密データを入力してはいけません。業務の検証を行う際は、社名や人名を架空の名称に置き換えたダミーデータを作成して入力します。
Q. リーダーボードの順位はどのくらいの頻度で更新されますか?
利用者の投票データは常時集計されており、リーダーボードはおよそ週に1回から数日のペースで定期更新されます。各社が新モデルをリリースした直後や、ステルスモデルの正体が明かされたタイミングでは、臨時のデータ更新が行われます。常に最新の序列を把握したい場合は、週に一度リーダーボードの上位陣の変動を巡回するのが合理的です。
Q. Chatbot Arenaで1位のモデルを選べば間違いありませんか?
総合1位のモデルがすべての企業や業務にとって最適とは限りません。総合順位は英語圏の日常会話プロンプトの比率が高く、日本語の自然さやプログラミング能力の順位とは乖離が生じるケースがあります。APIの利用料金や出力速度、社内システムのセキュリティ要件もモデルごとに大きく異なります。総合順位だけでなく、目的別タブのスコアと利用コストを照らし合わせて選定することが不可欠です。
チャットツールの実力差を把握した後は、業務現場で直ちに対話を開始できるおすすめの環境を整えましょう。主要モデルの基本機能や料金プランの全体像を整理したいなら、AIチャットボットの解説を先に読むと、本記事で選定したモデルを即座に日々の実務へ導入できます。
各ツールの公式サイト(一次情報)
料金・機能・対応範囲は各社公式が一次情報です。本記事は公開時点の検証に基づきますが、最新かつ正確な条件は必ず各公式ページで確認してください。