ChatGPTの発表内容
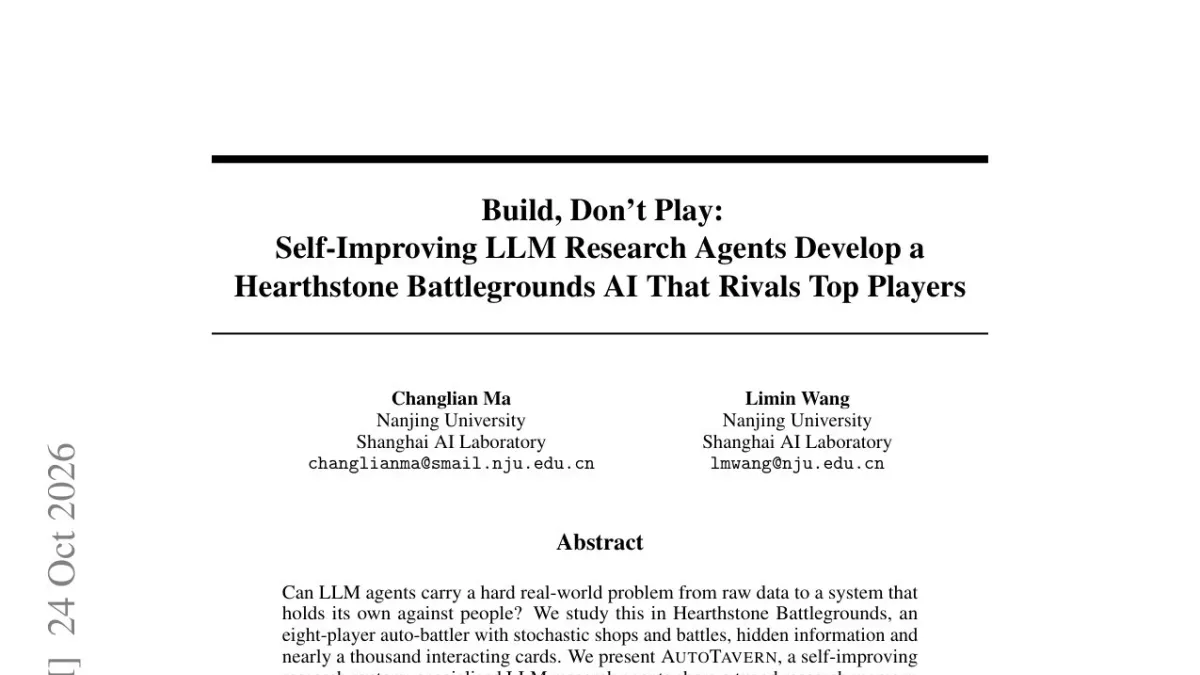
南京大学などの研究者らは、「ChatGPT」のモデルなどを活用して専用AIを開発させ、カードゲームの本番ランク戦でサーバー首位の勝率を収めたと発表しました。直近の研究において、AIが自ら構築したモデルが上位の人間の成績を上回りました。
実験では「GPT-6.1 Sol」や「GPT-6 Astra」、「Claude Opus 5.5」を頭脳にした6体のAIに、環境構築から訓練までを任せました。人間は目標設定や曖昧なルールの判断を行い、対戦時に指示されたキーを押す作業のみを担当しました。
AIが20日間かけて作った専用AIは、局面ごとの判断正答率が91%に達し、上位10人を上回る成績を記録しました。一方で「GPT-6 Astra」自身に直接判断させた場合の正答率は63%にとどまり、1手に数秒を要して実戦での対応が困難でした。
汎用的なAIを直接業務に使うのではなく、AIに専用のモデルを作らせる手法が有効となります。素早い判断や高い正答率が求められる実務において、現場に適した特化型AIを短期間で用意できるようになります。
つまり、どういうこと?
ざっくり言うと、優秀な万能選手に直接試合をさせるより、その選手に現場専任のコーチ役を任せて別の特化型AIを育てさせた方が、圧倒的に強くなったという結果です。
最新の大型AIは頭が良くても、回答に数秒かかります。20日間かけてゲーム専用のAIを仕立て直したことで、正答率91%という素早く正確な手筋を実現できました。
編集部の見方
AI自身が対戦するのではなく、専用モデルを作らせて勝率首位を取ったという実験結果に、筆者はかなり驚きました。直接操作させたときの正答率が63%にとどまる一方、20日間かけて作らせた専用AIが91%に達した落差は明確です。
AIがAIを育てる時代。
ただ、1手に数秒かかる汎用モデルをそのまま実戦に投入するのは、さすがに無理がありました。現場のスピードが求められる実務でも、同様の分業手法が主流になりそうです。今後は年末にかけて公開される次世代モデルのベンチマークにおいて、自作エージェントの作成能力がどう評価されるかを注視したいところです。
誰に関係するか
高速かつ正確な判断が必要な業務に取り組んでいる人は、汎用AIに専用AIを作らせることで高い処理精度を確保できるようになります。
出典: AIDB 公式 X ↗