

国産AIの導入判断で失敗しない基準は、海外製メガモデルとの単純な汎用性能勝負ではなく、自社のセキュリティ要件とインフラ環境に合致するかどうかです。自社の業務データや顧客情報を海外サーバーへ送信できない企業にとって、国内完結の選択肢は欠かせません。社内規定の壁に阻まれて生成AIの現場展開が進まない状況に、頭を悩ませていませんか。
国内ベンダーの技術開発が進み、日本語特有の言い回しや特定業界の専門用語に特化したモデルが次々と実用化されています。海外製LLMのAPIを国内サーバー経由で安全に中継する法人向けSaaSも選択肢が揃いました。
自社に必要な安全基準を満たし、現場の業務を着実に前進させる国産AIの選び方を整理してお伝えします。
国産AIとは?2つの区分と基本定義
国産AIとは、日本国内の企業や研究機関が独自に開発した言語処理モデル、および国内法に準拠して運用される法人向け生成AIプラットフォームの総称です。
この分類を曖昧にしたまま製品選定を進めると、基盤モデルの開発会社とフロントエンドのアプリケーション企業を混同し、セキュリティ設計やコスト計算で食い違いが生じます。社内提案を通すためにも、まずは2つの層を切り分けて把握しましょう。
自社開発の大規模言語モデル(独自基盤LLM)
独自基盤LLMは、日本語の事前学習データセットを自社で構築し、パラメーターの最適化を自社で行った基盤技術です。代表例としてNTTのtsuzumi、NECのcotomi、Preferred NetworksのPLaMo、ELYZAの日本語LLM、Sakana AIのモデルマージ技術による派生モデルが該当します。
最大の特徴は、モデルそのものを自社の閉域網やオンプレミスサーバーに配置できる点にあります。自社の社内データが外部の学習用サーバーに送信されるリスクを設計レベルでゼロに抑えられるため、金融・医療・自治体など厳しい規制を受ける組織で選ばれています。
業務向け生成AIサービス(国産AIラッパー/プラットフォーム)
業務向けサービスは、GPTやClaude、Geminiといった海外製最先端モデル、あるいは国産LLMをバックエンドに組み込み、国内企業のガバナンスに合わせて提供されるSaaSです。JAPAN AIやエクサベースAIがこの枠組みに入ります。
ユーザーが入力したプロンプトをAIモデルの再学習に使わせないマスキング機能や、国内データセンターでの通信終端、社内ポータルとしての権限管理画面が最初から整っています。基盤モデルを一から育てる投資余力がない企業でも、月額数千円単位のID課金で明日から安全なAI環境を配備できます。
この2層の違いを理解したうえで、自社が求めているのが「モデルそのものの自社専有」なのか「ガバナンスが効いた安全な業務画面」なのかを峻別してください。

編集部のおすすめ
ChatGPT・
複数のAIに同じ質問をして答えを比べたり、講座で使い方を体系立てて学んだりできます。

初月10ドルオフ(新規ユーザー)
ChatGPTやClaudeへの長い指示を、打たずに声で入力できる。日本語にも対応し、Mac・Windowsのどのアプリでも使える(無料は1,000語まで)
AI音声・文字起こし / 最低料金 ¥0〜
なぜ今国産AIが選ばれる?3つの明確な導入動機
海外の巨大IT企業が桁違いの計算資源を投じるなかで、なぜ国内企業が国産AIを選ぶのか。その理由は、汎用的な知能テストの点数ではなく、日本の商習慣と法的要件に根ざした実務上の制約にあります。
機密情報とデータ主権の確保
最大の動機は、個人情報保護法や社内コンプライアンスに基づくデータ主権の維持です。海外ベンダーのクラウドサービスを利用する場合、データの保管地域(リージョン)を日本国内に指定できたとしても、準拠法が米国法であったり、非常時のアクセス管轄に懸念が残ったりするケースが散見されます。
国産LLMや国内拠点の業務SaaSであれば、データの送受信・保管・破棄の全プロセスが日本法の下で管理されます。金融機関のFISC安全対策基準や、医療情報の3省2ガイドラインへの適合を求められる現場では、この法的な透明性が採用の決定打となります。
オンプレミス環境や閉域網での運用ニーズ
研究開発データや製造業の図面データなど、インターネットから完全に隔離された閉域網でしか扱えない機密を抱える企業があります。海外製最先端LLMの多くはクラウドAPI経由でのみ提供されており、完全オフラインの環境には持ち込めません。
パラメーター数を絞り込んで軽量化した国産LLMであれば、自社が保有するGPUサーバーやedgeデバイス上で直接動作します。外部ネットワークと物理的に切断された工場や研究所のなかでも、高度な言語処理やマニュアル検索を実現できる強みは代替が利きません。
日本の商習慣や業界用語への適応力
日本のビジネス文書には、特有の敬語表現、稟議書の定型フォーマット、業界ごとの慣用句が濃密に含まれます。海外モデルでも流暢な日本語の出力は可能ですが、文脈の行間を読んだニュアンスの調整や、日本の官公庁向け申請書類の作成では手直しが多発しがちです。
国内の特定産業向けにチューニングされたモデルは、医療カルテの専門記述や自治体の公用文規則を初期状態から理解しています。プロンプトで細かな文体指示を重ねなくても、現場の担当者が違和感なく読める日本語を一発で出力できる実用性が評価されています。
国産AIと海外製AIの違いは?保管場所・日本語・導入形態を比較
選択に迷ったときは、自社の要件を「データの保管場所」「日本語の処理能力」「導入形態の自由度」の3軸で照らし合わせてください。
次の表は、国産LLM、国内業務SaaS、海外製メガモデル(OpenAI・Anthropic・Google等)の運用仕様をまとめたものです。
| 比較項目 | 国産独自LLM | 国内業務向け生成AI | 海外製メガモデル |
|---|---|---|---|
| データの保管場所 | 自社指定サーバー / 完全国内データセンター | 国内サーバー(中継・暗号化処理) | 選択リージョン(海外または国内拠点) |
| 学習へのデータ利用 | なし(自社専有モデル) | 原則なし(SaaS側で契約制御) | オプトアウト設定により不使用 |
| 日本語の強み | 業界用語、公用文、方言、商習慣の行間理解 | 日本語プロンプトテンプレート、UIの最適化 | 汎用的な文法力、長文翻訳、膨大な知識量 |
| 導入形態 | オンプレミス、アプライアンス、専用API | クラウドSaaS、ブラウザ利用 | クラウドAPI、専用ポータル |
| インフラ費用 | 高(初期構築費用や専用GPUが必要) | 低(月額ID課金+従量料金) | 中(使った分だけの従量課金) |
| 導入難易度 | SIerによる個別設計が必要 | 契約後即日で利用開始可能 | アプリ開発やセキュリティ設計が必要 |
AI PICKS調べ: AIエージェントカテゴリの有料プラン中央値は月3,000円(n=56、2026-11-09時点)。料金統計レポートで見る
つまり、初期投資を抑えて手軽にセキュリティを固めたいなら国内業務SaaS、クラウド接続そのものを遮断したい最高機密用途なら国産独自LLMが適しています。
海外大手クラウドを基盤にしたセキュアな構成を検討したい企業は、エンタープライズ向けAI運用の比較解説をあわせて確認するとインフラ設計の解像度が上がります。
毎週月曜の朝に、今週のSakana AIのニュースとアップデートを先頭に、AI全体の主なニュースと新しく載ったツールをまとめて届けます。登録特典は「AIツール選定チェックリスト 2026」。
確認メールのボタンを押すと登録が完了します。配信はいつでも解除できます。
国産独自LLM主要5モデルの特徴と公開状況
ここからは、日本国内で独自に開発されている代表的な基盤モデル5選を整理します。各社の公式発表に基づく提供形態と強みを把握してください。
1. tsuzumi(NTT)
NTTが2023年11月に公式発表した「tsuzumi」は、高い日本語処理性能を維持しながら軽量性を追求した大規模言語モデルです。
数十億〜数十億規模の比較的小さなパラメーターサイズで構成されており、高価なハイエンドGPUクラスタを大量に並べなくても、一般的なGPUサーバー1基で高速に推論を実行できます。オンプレミス環境やエッジサーバーへの組み込みを前提に設計されている点が、他社モデルとの大きな違いです。
聴覚や視覚のマルチモーダル受容にも対応を進めており、自治体の窓口業務、コンタクトセンターの通話要約、社内マニュアルのローカル検索システムなどで商用導入が進められています。
2. cotomi(NEC)
NECが2023年7月に発表した「cotomi(コトミ)」は、企業や官公庁の基幹業務向けに最適化されたLLMです。
長文読解と高速なレスポンス性能を両立させ、業種別の特化モデル(金融・製造・ヘルスケア・公共)を順次展開しています。NECの自社スーパーコンピュータで事前学習が行われており、セキュアなプライベートクラウドおよびオンプレミス環境でのアプライアンス提供が用意されています。
自社独自の業務文書を短期間で追加学習させるカスタマイズサービスが充実しており、企業の基盤システムと直結させた閉域生成AIとしての採用実績を積み上げています。
3. PLaMo(Preferred Networks)
AI創薬やロボティクスで知られるPreferred Networks(PFN)が2023年9月に発表したオープンな基盤モデルが「PLaMo(プラモ)」です。
自社設計の省電力AIアクセラレータや国内の大規模計算基盤を活用してゼロからフルスクラッチで学習されています。日本語と英語の双方で高いトークナイズ効率を誇り、製造業の設計支援やプログラミングコード生成、科学技術計算の支援領域で高い適合性を示します。
ライセンス形態や産業向けAPIの提供など、国内産業の足腰を支える基盤技術としての実用化に注力しているのが特徴です。
4. ELYZA LLMシリーズ(ELYZA)
東京大学松尾研究室発のスタートアップでKDDIグループに参入したELYZAは、2023年から2024年にかけて高性能な日本語LLMを連続して公開しています。
MetaのオープンソースモデルであるLlamaシリーズをベースに独自の日本語追加事前学習と高品質な指示チューニングを施したモデルを展開。グローバル最高峰のオープンモデルの強みを活かしつつ、日本語の流暢さと推論能力を大幅に引き上げた実務的な仕立てが特徴です。
API提供や専用クラウド環境でのホスティングに対応しており、カスタマーサポートの自動返信やコンタクトセンターの通話分析など、自然な日本語対応が求められる接客現場で重宝されています。
5. Sakana AI(進化型モデルマージ)
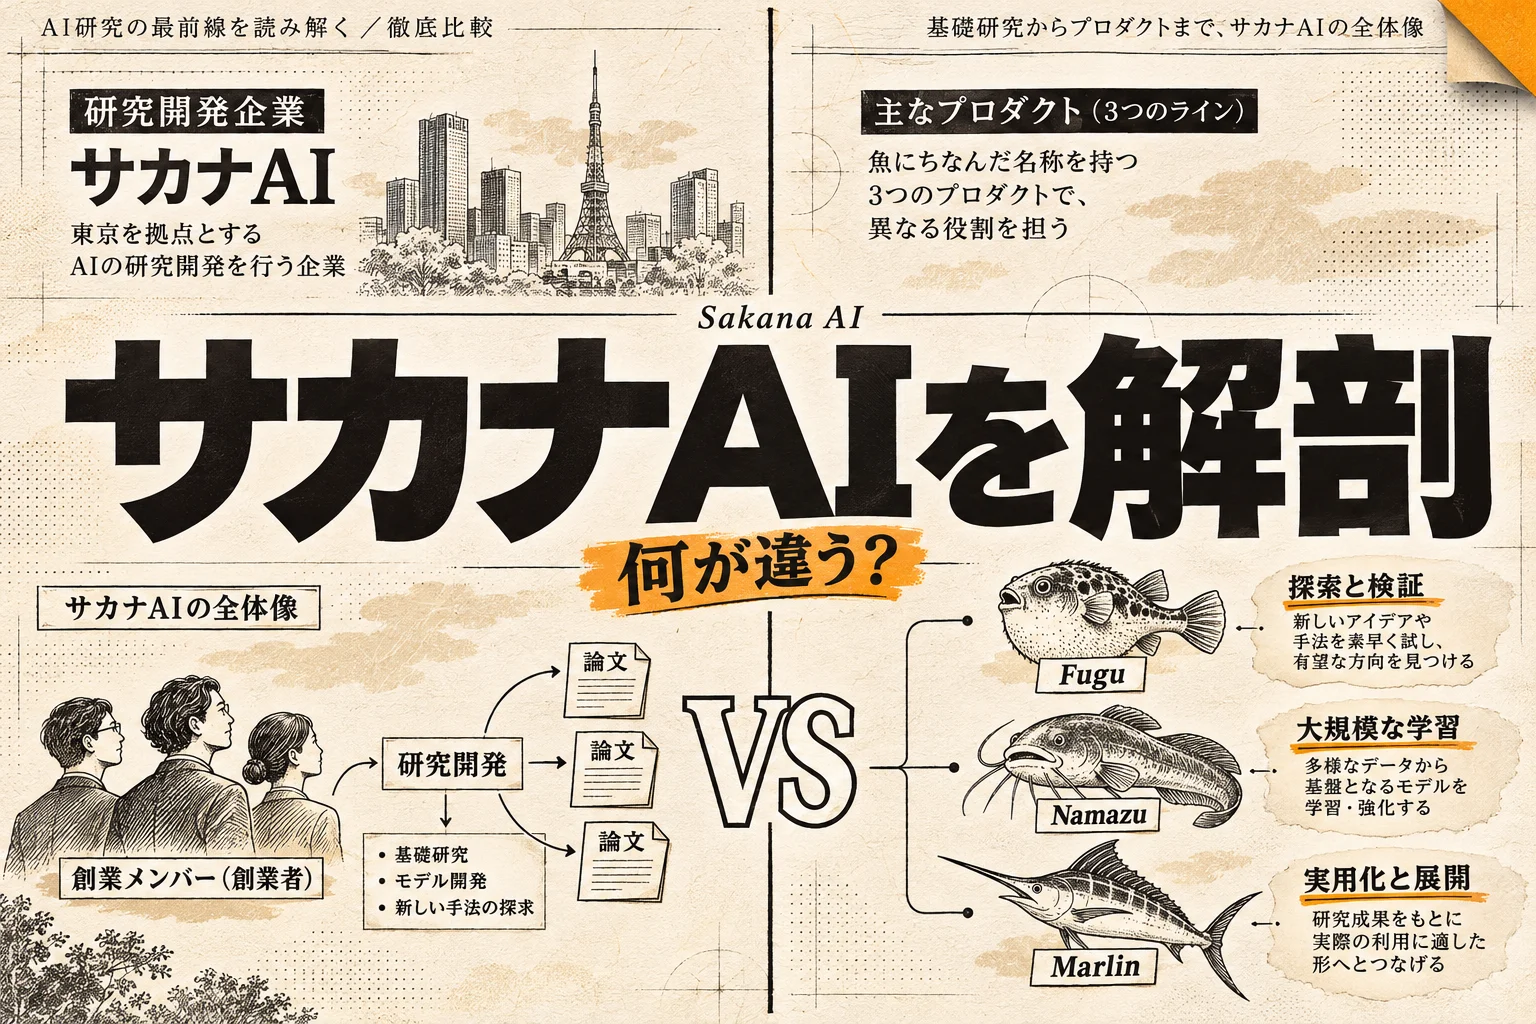
元Googleの研究者らが東京で創業したSakana AIは、自然界の進化論に着想を得た独自のアプローチで注目される研究開発型企業です。2024年に複数の学習済みモデルを掛け合わせて新たな能力を生み出す「進化的モデルマージ」技術を発表しました。
膨大な電力と計算資源を消費して巨大モデルを一から学習させるのではなく、既存の優れたモデル同士を自動的に組み合わせて日本語や数学、画像認識に長けた新モデルを効率的に生成します。
計算リソースの制約が厳しい日本市場において、軽量かつ低コストで目的特化型モデルを生み出す新潮流として存在感を確立しています。

業務向け国産生成AIツール(SaaS)の料金と機能
基盤モデルを独自運用するのではなく、ブラウザから安全にログインして使える業務プラットフォームを求める企業には、国内SaaSが最適です。
次の表は、公開情報に基づく代表的な国内業務向け生成AIツールの仕様をまとめたものです。
| ツール名 | 提供会社 | 料金体系 | 特徴と |
|---|---|---|---|
| JAPAN AI | JAPAN AI株式会社 | Team: 1人あたり月額2,980円(1〜50名) ※51名以上は個別見積もり | 国内データ保管、学習利用なし。 Slack・kintone・Salesforceなど30以上の外部ツールと連携可能。 |
| エクサベースAI (旧exaBase生成AI) | 株式会社エクサウィザーズ | 1IDあたり月額900円+従量料金 | 国内サーバー処理。GPT・Claude・Geminiを管理画面から選択可能。 150種以上の実務テンプレートを標準搭載。 |
| リンネAI | 株式会社トレンドタウン | 初期費用99,000円+月額9,900円〜(税別) | ユーザー数無制限(ID無制限課金)。 データの学習利用を強力に防止、中小企業の全社導入向け。 |
つまり、部署単位で少人数から試すならエクサベースAI、全社でID数を気にせず共有するならリンネAI、外部SaaS連携を深めるならJAPAN AIという明確な棲み分けが成り立ちます。
他のライティング専用ツールとの違いを把握したい場合は、文章生成AIの料金と選び方をまとめた比較記事も参考になります。
国産AI導入時に確認すべきセキュリティ基準は?
企業が国産AIを選定する最大の理由はセキュリティです。しかし「国産だから無条件に安全」と思い込むのは落とし穴。調達部門や情報システム部門が確認すべきチェックリストを押さえましょう。
データがAIの再学習に使われない契約(オプトアウト)
入力した社外秘情報や顧客データが、AIモデルの精度向上や次回学習データセットに取り込まれないことが大前提です。
国内SaaS製品の場合、利用規約上で「入力データは学習に一切使用しない」と明記されているかを確認してください。自社専用LLMをオンプレミスで運用する場合は物理的に外部送信されないためクリアできますが、外部APIを経由する構成をとる場合はベンダー側のログ保持期間(Data Retention Policy)まで確認が必須です。
データの保管場所と通信経路の国内限定
クラウドサービスを利用する場合、プロンプトデータや生成結果がどの地域のサーバーに保存されるかを確認します。「国内データセンター運用」と謳っていても、負荷分散の過程で一時的に海外リージョンを経由するアーキテクチャになっていないか、ネットワーク経路の確認を怠ってはいけません。
通信路の暗号化(TLS 1.3)や保存データの暗号化(AES-256)はもちろん、自社専用のプライベートIP接続(AWS PrivateLinkやAzure ExpressRouteなど)に対応しているかどうかも重要な判断軸です。
権限管理と監査ログの出力機能
社内の誰が・いつ・どのようなプロンプトを入力し・何が出力されたかを追跡できる監査ログ機能は、内部統制の観点から欠かせません。
役職や所属部署ごとに利用できる機能や閲覧範囲を制限するロールベースアクセス制御(RBAC)や、シングルサインオン(SAML認証/Active Directory連携)が備わっているかを確認してください。個人情報や不適切な単語の入力を検知して自動でブロックするマスキングフィルターの有無も、現場展開の安心感を左右します。
業界別の国産AI活用シナリオ
汎用的な海外モデルでは対応しづらい領域で、国産AIがどのように実務を支えているのか。具体的な3つのシナリオを解説します。
金融機関・保険会社:閉域網での規定集・約款照会
金融機関では、顧客の財務情報や口座情報を含むデータを外部クラウドに送信することが社内規定で厳格に禁じられています。
こうした環境では、オンプレミス型やアプライアンス型の国産軽量LLMが重宝します。数十万ページに及ぶ社内規定集や保険約款をローカル環境でベクトル検索(RAG)と連携させ、社内ネットワークから一歩も外に出さずに職員の問い合わせ対応を自動化できます。法改正に伴う規定更新の際も、社内サーバー内で安全に差分チェックを完結できます。
自治体・公共機関:住民窓口の公用文作成と申請書チェック
地方自治体では、住民の個人情報を扱うためLGWAN(総合行政ネットワーク)環境での運用が求められます。
公用文特有の言いまわしや法令用語のルールに精通した国産モデルを活用することで、職員が作成した広報文書や通知文書のチェック作業を大幅に省力化できます。窓口での手続き案内においても、専門的な申請書類の記入方法を住民向けに分かりやすく言い換えるアシスタントとして活用されています。
製造業・研究開発:独自図面や特許情報の知財保護
製造業のコア技術に関わる図面データ、材料配合比、実験レポートは企業の生命線です。万が一にも外部の学習データに流出することは許されません。
開発拠点内の専用サーバーにPLaMoやtsuzumiのような独自モデルを配備し、過去数十年分の研究日誌や特許出願書類をインデックス化する動きが加速しています。エンジニアが技術的なブレインストーミングや過去の失敗事例を検索する際、外部接続のないセキュアな環境下で安心して壁打ち相手として機能します。
コストと運用の落とし穴!独自LLMとSaaSの分岐点
国産AIの導入を検討する際、多くの企業が見落としがちなのが「運用にかかるトータルコスト(TCO)」です。
独自LLMの構築・保守には莫大な固定費がかかる
「完全自社専用のLLMを社内サーバーで動かしたい」という要望はセキュリティ上もっともですが、それには相応のインフラ投資と専門人材が必要です。
GPUサーバーのハードウェア調達費用に加え、データセンターの電力代、冷却設備、モデルの再チューニングや運用監視を担う機械学習エンジニアの人件費が発生します。初期構築だけで数千万円、年間運用費で数千万円規模の予算が固定化するケースも珍しくありません。
9割の一般企業は国内SaaSのID課金が合理的
自社で基盤モデルを所有する必要性が「絶対的な物理隔離」にない限り、一般の事業会社にとっては月額1人あたり数百円〜数千円で利用できる国内業務SaaSを選ぶのが賢明です。
インフラの保守や最新モデルへの追従、セキュリティパッチの適用はすべてSaaSベンダー側が担ってくれます。まずはスモールスタートで1つの部署から導入し、現場の利用実態や業務改善効果を測定しながらID数を拡大していく進め方が、投資対効果の面で最もリスクを抑えられます。
AI PICKS編集部の判定
国産AIの導入において、汎用性能の高さだけを求めて海外製メガモデルと直接競合させる姿勢は正直イマイチです。言語理解の幅広さや長文コーディング、マルチモーダル処理の絶対的な馬力では、莫大な投資を続ける海外の先端モデルが優位を保ち続けています。
しかし、評価の軸を「自社の法務規定を突破できるか」「オンプレミスや閉域網で動くか」「日本の商習慣に根ざした業務に馴染むか」に置いた瞬間、国産AIは圧倒的な存在感を発揮します。
編集部の率直な見立てとして、完全なインターネット遮断が義務付けられている最高機密領域や特殊な現場端末向けには、1台のGPUサーバーで軽快に動作するNTTの「tsuzumi」が一択です。この軽量性と専有運用力は、巨大クラウドありきの海外サービスでは代替できません。
一方で、日常のオフィス業務をセキュアに効率化したい大多数の一般企業であれば、モデル開発に投資するのではなく、エクサベースAIのような「国内サーバー処理かつ主要モデルを切り替えられる業務SaaS」を選ぶのが最も破格で費用対効果に優れます。
自社の情報セキュリティポリシーの厳しさに応じて「閉域の独自LLM」か「国内SaaS」かを冷徹に見極めることが、失敗を避ける唯一の正解です。
よくある質問(FAQ)
Q. 国産AIはChatGPTやClaudeなどの海外製モデルと比べて性能が低いですか?
一般的な知識量や多言語翻訳、複雑なプログラミング能力を総合したベンチマークテストでは、海外製メガモデルが優勢な傾向にあります。ただし、特定の業界用語の理解、公用文の作成ルール、日本固有の慣習に配慮したニュアンス調整においては、国内特化でチューニングされた国産モデルが実務上で扱いやすい場面も多く存在します。用途を限定して比較することが肝要です。
Q. 無料で利用できる国産AIツールはありますか?
個人向けの無料チャットアプリとしては一部の実験的サービスが存在しますが、法人向けの業務ツールや独自LLMに関しては、原則として有料の商用ライセンスまたは個別見積もりでの提供となります。多くの国内SaaSベンダーが法人向けの無料トライアル期間を用意しているため、契約前に自社データでの検証が可能です。
Q. 国産AIを使えば情報漏洩のリスクは完全にゼロになりますか?
外部へのデータ送信や学習利用を遮断する設計により、クラウドを介した外部流出リスクは極めて低くなります。しかし、社内ユーザーによる不正持ち出しやアカウント管理の不備、フィッシング詐欺など、運用上の人為的ミスに起因する漏洩リスクまでは防げません。アクセス権限の設定や利用ログの定期監査をセットで運用する必要があります。
Q. 自社専用にチューニングした独自LLMを作るには何が必要ですか?
追加学習に用いる自社固有のクリーンなテキストデータ(社内規定、マニュアル、過去の業務履歴など)と、学習・推論を実行するためのGPU計算資源、およびAIエンジニアの知見が必要です。最近ではモデル構築からインフラ整備までを一気通貫で支援する国内SIerの伴走支援パッケージを活用する事例が増えています。
Q. 国産AIツールを選ぶ際、情報システム部門は何を基準に審査すべきですか?
第一に「入力データの学習利用の有無と規約上の明文化」、第二に「データの保存場所(国内データセンター指定が可能か)」、第三に「SAML認証など既存ID基盤との連携可否」の3点です。これらに加えて、従業員のプロンプト履歴を追跡・監査できる管理者機能が備わっているかを必ず審査してください。
Q. オープンソースの日本語モデルを社内サーバーで自前運用することは可能ですか?
可能です。ELYZAやPFNなどが公開しているオープンな重みデータをダウンロードし、社内のプライベートクラウドやオンプレミスサーバーにデプロイして運用する構成が選択できます。外部への通信を一切発生させずに運用できる反面、サーバーの保守やAPIエンドポイントの管理を社内のエンジニアが担当する必要があります。
あわせて見たいツール・カテゴリ
自社のAI環境構築や業務効率化を多角的に進めるために、関連するツールや活用ガイドも参考にしてください。
- Sakana AIの機能詳細と特徴
- ELYZAの日本語モデル詳細
- AIセキュリティ関連ツールの比較と解説
- 業務自動化を推進するAIオートメーション製品
- 社内業務を効率化するAI生産性ツール一覧
- 日本企業向けAIツール厳選ガイド
- 日本語AIライティングの文体比較
社内文書作成や要約の自動化から着手したい場合は、日本企業の現場で活用が進むAIツール20選をあわせて読むと、自社の業務課題に直結する製品が見つかります。
参考にした一次情報
記事の事実関係は、次の公式ページで確認しています。仕様や料金は変わることがあるため、最新の内容は各ページで確かめてください。
- NTTニュースリリース「tsuzumi」商用化(公式):2023年11月1日発表。6億と70億パラメータの2種で、軽量版は1GPUで推論できます(2026年11月確認)
- NTT STORY「tsuzumi」商用開始(公式):2024年3月25日に商用開始。軽量なためオンプレミスやプライベートクラウドで使えます(2026年11月確認)
- ELYZAお知らせ「7Bモデル公開」(公式):2023年8月29日、Llama 2ベースの70億パラメータ日本語LLMを商用利用可能な形で一般公開(2026年11月確認)
- ELYZAお知らせ「Llama-3-ELYZA-JP」(公式):2024年6月26日、80億パラメータモデルを商用利用できる形で一般公開しました(2026年11月確認)