Mixtralの代わりを探すときは、同じ専門家混合(MoE)の構造にこだわる必要はありません。自社のPCやサーバーで安全に動かしたいのか、それとも安いAPIに乗り換えて運用負担を減らしたいのか。この目的を最初に決めると、乗り換え先は自然に決まります。
手元での実行ならLlama 3やELYZA、APIの安さならMistralの新型モデルが有力候補です。乗り換えで後悔しないための比較基準と具体的な手順を整理しました。
Mixtralとは?仕組みと強みを3分で把握する
Mixtralとは、フランスのMistral AI社が重みを公開したオープンウェイトの大規模言語モデルです。最大の特徴は、専門家混合(Sparse Mixture of Experts、略してSMoE)という内部構造を採用している点にあります。
質問を受けるたびにモデル全体の計算を回すわけではありません。入力された文章の内容に応じて、内部にある専門パートのうち必要な部分だけを選んで動かします。
動かすパラメータ数を抑えられるため、回答の生成速度が速い点が強みでした。公開当時の基準では、はるかに大きなサイズのモデルに近い賢さを保ちながら、軽い推論負荷で動作したため人気を博しました。
もうひとつの利点は、モデルの重みデータが無償で配られたことです。利用者は自分のパソコンや会社の専用サーバーにデータを落とし、外部通信を遮断した状態で推論を実行できます。社外秘の議事録や顧客データをクラウドに送信したくない現場で、重宝されてきました。
ライセンスが緩やかなApache 2.0だった点も普及を後押ししました。自社サービスの裏側に組み込んで商用展開するハードルが低かったからです。
スペックの推移や詳細な系譜は、Mixtralの個別解説ページに整理してあります。

編集部のおすすめ
ChatGPT・
複数のAIに同じ質問をして答えを比べたり、講座で使い方を体系立てて学んだりできます。

初月10ドルオフ(新規ユーザー)
ChatGPTやClaudeへの長い指示を、打たずに声で入力できる。日本語にも対応し、Mac・Windowsのどのアプリでも使える(無料は1,000語まで)
AI音声・文字起こし / 最低料金 ¥0〜
Mixtralの代替が必要になる3つの理由とは?
導入済みのモデルを別のものへ載せ替える作業には、検証の手間と時間がかかります。それでも乗り換えの相談が増えている背景には、共通する3つの課題があります。
[課題の洗い出し]
├─ 1. 世代交代による性能差(2026年の小型モデルが過去の大型を上回る)
├─ 2. 日本語特有の表現力不足(敬語の破綻、突然の英語混ざり)
└─ 3. 運用コストとGPU確保の負担(自前サーバー維持の手間)
ひとつめは、モデルの世代交代です。2024年以降に登場した新しいオープンウェイトモデルは、学習データの質が上がっています。Mixtralと同じかそれ以下の計算資源でも、論理的な受け答えの精度が高くなりました。
ふたつめは、日本語の表現力です。Mixtralは英語や欧州言語には強い反面、日本語の敬語表現がぎこちなくなったり、指示の途中で英語に戻ってしまったりする場面が目立ちました。社内向けチャットボットなら許容できても、一般顧客への自動応答では手直しが必要です。
みっつめは、計算資源の維持管理です。Mixtral 8x7Bを実用的な速度で動かすには、大容量のメモリを積んだ高価なGPU(画像処理装置)が欠かせません。クラウドAPIが大幅に値下がりしたことで、自前サーバーを維持する割高感が浮き彫りになりました。
困りごとの正体が日本語なのか、運用コストなのか。ここを切り分けることが乗り換えの第一歩です。
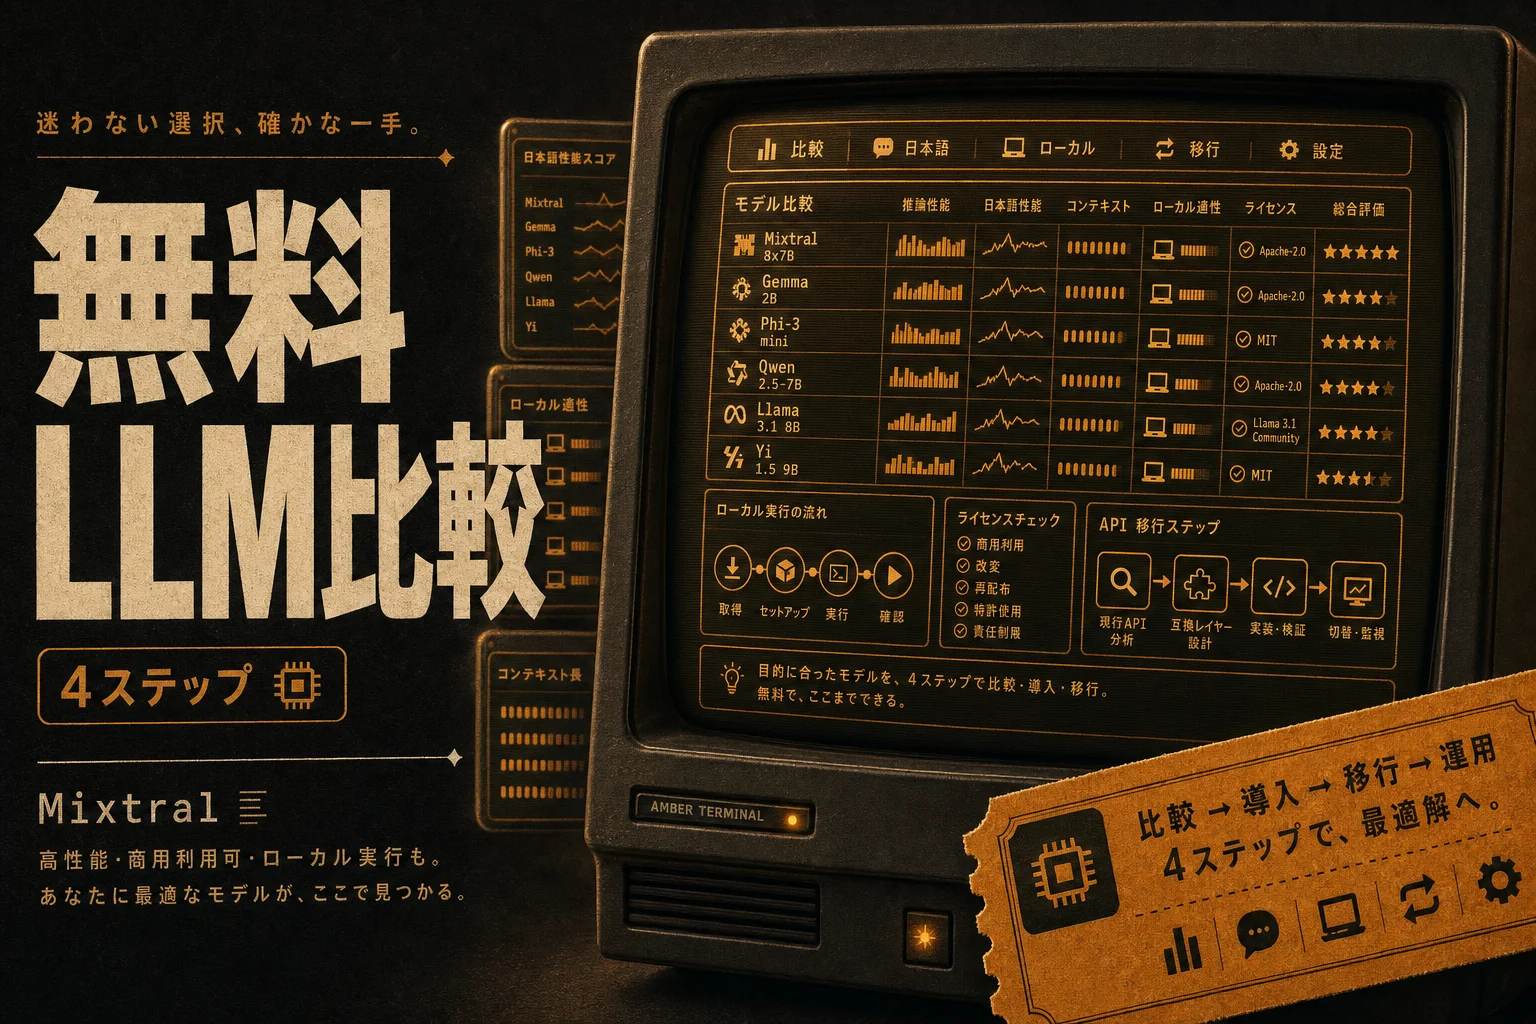
無料で使えるオープンソースLLMの比較表
手元で動かせるオープンウェイトモデルから、Mixtralの乗り換え先として有力な選択肢を整理しました。
| モデル名 | 開発元 | ライセンス | 日本語の | 推奨される |
|---|---|---|---|---|
| Llama 3.1 (8B/70B) | Meta | Llama 3.1コミュニティ | 良好 | 8B: VRAM 16GB / 70B: VRAM 48GB超 |
| ELYZA (Llama系派生) | ELYZA | モデルごとの利用規約 | 非常に高い | VRAM 16GB〜 |
| Qwen 2.5 (7B/14B/72B) | Alibaba | Apache 2.0など | 良好 | 7B: VRAM 16GB / 14B: VRAM 24GB |
| DeepSeek系モデル | DeepSeek | 独自オープン規約 | 良好 | 規模に応じてVRAM 16GB〜 |
| Mistral Small 4 (自前実行版) | Mistral AI | 非商用または商用契約 | 中程度 | VRAM 24GB〜 |
つまり、完全な商用自由度を求めるならApache 2.0の系統、自然な日本語を最優先するなら国内開発チームによる追加学習モデルが候補になります。
手元での実行を完全無料で行うには、電気代とハードウェア購入費を除けば、オープンウェイトの利用が基本です。ただしモデルによって利用規約が異なります。利用者が一定規模を超える場合に申請が必要なライセンスもあるため、事前の規約確認を怠ってはいけません。
他のモデル群も広く見比べたいときは、AIチャットボットカテゴリに機能ごとの分類があります。
毎週月曜の朝に、今週のMistral AIのニュースとアップデートを先頭に、AI全体の主なニュースと新しく載ったツールをまとめて届けます。登録特典は「AIツール選定チェックリスト 2026」。
確認メールのボタンを押すと登録が完了します。配信はいつでも解除できます。
Mixtralの代わりになるおすすめLLM5選
Mixtralの置き換えとして現実的な候補を5つに絞りました。特徴と注意点をそれぞれ挙げます。
1. Llama 3.1(8B / 70B)
世界中で最も利用例が多いオープンウェイトモデルです。
- 強み: 開発コミュニティが活発で、トラブル時の解決策が見つかりやすい
- 注意点: 月間アクティブユーザー数が7億人を超える大規模商用利用にはMetaへの申請が必要
- 向いている用途: 一般的な社内文章の要約、分類、データ抽出
8Bモデルであれば、一般的なワークステーションや業務用の高性能PCでも動作します。70BモデルはMixtral以上の推論精度を発揮しますが、複数のGPUを積んだサーバー環境が必須です。
2. ELYZA(国内追加学習モデル)
日本語でのやり取りを最優先したい場面で頼りになるモデルです。
- 強み: 不自然な敬語や不意の英語混ざりが発生しにくい
- 注意点: 海外の大型モデルに比べると、多言語翻訳や高度なプログラミング処理で差が出る場合がある
- 向いている用途: 顧客向けメールの下書き作成、社内マニュアルのQ&A窓口
日本語の語順やビジネス文書の定型表現に慣れているため、生成された文章の修正作業を大幅に減らせます。国内の文脈を重んじる業務チャットボットの置き換えに合います。
3. Qwen 2.5(7B / 14B / 72B)
多言語処理とコーディング支援で高い能力を持つオープンウェイトモデルです。
- 強み: 数学的な計算やコード生成、アジア圏言語の処理が安定している
- 注意点: 学習データの傾向により、特定の話題に対する回答表現に偏りが出る可能性がある
- 向いている用途: 社内ツールのコード補助、多言語ドキュメントの翻訳と整理
14Bサイズは、推論速度と精度のバランスが優れています。単一の高性能GPUでも量子化(データの軽量化処理)を施せば実用的な速度で動作します。
4. Mistral Small(APIまたは重み利用)
Mixtralと同じMistral AI社が提供する後継の小型モデルです。
- 強み: 指示文の書き方や癖がMixtralに近く、移行の手間が最も少ない
- 注意点: 商用利用のライセンス形態がモデル世代ごとに細かく分かれている
- 向いている用途: 既存のMistral系プロンプト資産をそのまま活かしたいシステム
APIで利用する場合、入力100万トークンあたり約0.15ドルから0.20ドルという安さで使えます。自前でGPUを確保する費用と天秤にかけたとき、API利用への切り替えでコストが下がるケースも少なくありません。
5. Claude 3.5 Haiku(クラウドAPI)
オープンソースにこだわらず、運用の手離れの良さを選ぶ場合の有力候補です。
- 強み: 敬語の滑らかさと指示への追従性が高く、社内保守の手間がゼロになる
- 注意点: 社外のクラウドへ文章データを送信する契約になる
- 向いている用途: 機密データを含まない日常業務の自動化、外部向けサポート
Claudeは日本語のニュアンス理解に定評があります。自前サーバーの保守監視から解放されたい現場では、有力な選択肢になります。
日本語精度で選ぶならどのモデル?
日本語のやり取りを自動化するなら、海外の大型モデルをそのまま使うより、日本語で追加学習されたモデルを選ぶのが近道です。
英語圏のモデルは、日本語を処理するときに文字の分解(トークン化)が細かくなりやすい傾向があります。処理する文字のかたまりが増えるため、回答速度が落ち、文脈を見失いやすくなります。
[日本語処理の比較]
海外製汎用モデル: 日本語のトークン分割が細かく、回答生成が遅くなりやすい
国内特化モデル  : 日本語の単語単位で効率的に処理し、敬語や文脈の破綻を防ぐ
社内マニュアルを読み込ませて回答させる用途では、文章の言い回しが自然でないと社員に使われません。「てにをは」の乱れや不自然な直訳調をなくすなら、ELYZAなどの国内派生モデルが一択です。
一般的な文章作成ツール全般の動向を知りたい場合は、AIライティングカテゴリの解説が参考になります。
ローカル環境でLLMを動かすためのGPU要件
Mixtralやその代替モデルを手元で動かす際、最大のボトルネックになるのがGPUのメモリ(VRAM)容量です。
通常のパソコンのメインメモリと異なり、GPU専用のメモリにモデルの重みデータを丸ごと読み込む必要があります。容量が1ギガバイトでも不足すると、処理速度は極端に低下します。
| モデル規模 | 必要VRAM | 必要VRAM | 動作が |
|---|---|---|---|
| 7B〜8Bクラス | 約16GB | 約6GB〜8GB | RTX 4060Ti (16GB) / M2・M3 Mac (16GB以上) |
| 14Bクラス | 約28GB | 約10GB〜12GB | RTX 4070Ti / M3 Mac (24GB以上) |
| Mixtral 8x7B | 約90GB | 約32GB〜48GB | A100 (40GB/80GB) / RTX 3090/4090 2枚挿し |
| 70Bクラス | 約140GB | 約40GB〜48GB | A100 (80GB) / 高構成ワークステーション |
つまり、Mixtral 8x7Bをまともに動かす環境があれば、Llama 3.1の8Bや14Bクラスのモデルは余裕を持って高速動作させられます。
自社機材のスペックが限られている場合は、モデルの数値を4bit程度に圧縮する「量子化」を活用します。わずかな精度低下と引き換えに、必要なメモリ容量を半分以下に減らせます。
クラウドAPIへ乗り換える場合の料金と注意点
自前でのサーバー運用をやめてクラウドAPIに切り替える場合、月々の運用費は大幅に下がる可能性があります。
2026年現在のMistral AI公式APIの料金体系は以下の水準です。
[Mistral API 料金目安(100万トークンあたり)]
・Mistral Small 4 : 入力 $0.15 / 出力 $0.60
・Mistral Large 3 : 入力 $0.50 / 出力 $1.50
・Codestral       : 入力 $0.30 / 出力 $0.90
月に数万回の問い合わせを処理する程度であれば、月額数千円から数万円のAPI料金で収まります。毎月数十万円かかるGPUサーバーのレンタル費用や電気代と比べると、コスト差は歴然です。
ただし、クラウドAPIの利用にはデータの取り扱い規約が絡みます。入力したデータがモデルの再学習に使われない契約になっているか、サーバーの設置地域が自社のセキュリティ基準を満たしているか、規約の確認が必要です。
他社の主要チャットボットとの料金比較は、ChatGPTやGeminiの解説記事で詳細な内訳を掲載しています。
Mixtralから乗り換えるための4ステップ
モデルの乗り換えを安全に進めるには、段階を踏んだ検証が欠かせません。いきなり本番環境を切り替えると、出力形式の崩れで連携システムが止まる危険があります。
[移行の4ステップ]
ステップ1: 評価用の質問集(20〜30問)を作成する
   ↓
ステップ2: ローカル実行ツール(Ollama等)で候補モデルを試す
   ↓
ステップ3: 指示文(プロンプト)の調整と出力形式の固定
   ↓
ステップ4: 開発環境での並行稼働と社内テスト
ステップ1: テスト用の質問集を20問用意する
現在Mixtralに投げている代表的な指示文を20問から30問集めます。社内用語を含んだ質問、要約の指示、JSON形式での出力指定など、実際の業務で使うパターンを網羅します。
ステップ2: 軽量な環境で候補モデルの出力を比較する
OllamaやLM Studioといったローカル実行ツールを使い、候補モデルに同じ質問集を投げます。回答の自然さ、要約の正確さ、指定した文字数を守れるかを採点します。
ステップ3: 指示文の書き方を新しいモデルに合わせる
モデルが変われば、指示の効きやすい言い回しも変わります。「以下のルールを厳守してください」と強めに縛る必要があるのか、出力例(Few-shot)を1つ添えるだけで安定するのか、微調整を行います。
ステップ4: 開発環境で並行稼働させて最終確認する
既存のMixtralと新しい候補モデルを同時に動かし、同じ入力に対する挙動を比べます。エラーの発生頻度や返答速度に問題がないことを確認してから、本番の接続先を切り替えます。
AI PICKS編集部の判定
Mixtralの代替選びにおいて、編集部の結論は明確です。社外秘データを扱うためにローカル実行を続けたいなら「Llama 3.1(8B)」か「ELYZA派生モデル」の二者択一、運用の手間を減らしたいなら「Mistral SmallのクラウドAPI」への移行が一択です。
Mixtral 8x7Bを自前で運用し続ける選択は、現在となっては正直イマイチです。必要なGPUメモリが大きすぎる割に、最新の8B〜14Bクラスの単一モデルと比べて明確な性能差を出せなくなっているからです。
手元での実行を維持するなら、扱いやすさと日本語精度のバランスが取れた小型オープンウェイトへ縮小移行するのが現実的です。自前運用の呪縛を捨てられるなら、100万トークン数十セントで動く最新APIへ切り替えるほうが、費用面でも保守面でも圧倒的に身軽になります。
よくある質問(FAQ)
Q. Mixtral 8x7Bは商用利用できますか?
A. はい、Apache 2.0ライセンスで公開されているため、商用利用が可能です。自社の製品やサービスに組み込んで販売したり、社内業務の自動化に使ったりしてもライセンス料は発生しません。改変や再配布も許可されています。
Q. 自前のパソコンで動かすには最低どれくらいのスペックが必要ですか?
A. Mixtral 8x7Bを元の精度のまま動かすには、48GBから90GB以上のGPUメモリが必要です。家庭用の一般的なパソコンで動かすのは困難です。パソコン単体で動かしたい場合は、軽量化されたLlama 3.1の8Bモデルなどを選ぶのが現実的です。これなら16GB程度のメモリを積んだPCで動作します。
Q. クラウドAPIを使う場合、入力したデータは学習に使われますか?
A. 公式APIの有料契約では、送信したデータがAIの再学習に利用されない規約になっているのが一般的です。ただし無料枠や一部の外部ホスティングサービスでは、オプトアウト(学習拒否)の申請が必要な場合もあります。利用前に各社のデータ利用規約を確認してください。
Q. オープンソースLLMの日本語能力は実務で通用しますか?
A. 定型的な要約やデータ抽出、社内FAQへの回答といった用途であれば十分実務で通用します。ただし、情緒的な言い回しや複雑な法律文書の作成では、人手による確認が欠かせません。日本語の自然さを求めるなら、国内チームが調整したモデルの採用を推奨します。
次に読むならこれ オープンソースモデルを手元のPCで手軽に動かす具体的な手順を知りたい方は、動作環境の構築手順をまとめたAIコーディングツールまとめの記事を合わせて読むと、環境整備がスムーズに進みます。
各ツールの公式サイト(一次情報)
料金・機能・対応範囲は各社公式が一次情報です。本記事は公開時点の検証に基づきますが、最新かつ正確な条件は必ず各公式ページで確認してください。
- Mixtral:公式サイト(AI PICKSの詳細)
- Mistral AI:公式サイト(AI PICKSの詳細)
- Llama:公式サイト(AI PICKSの詳細)
- DeepSeek:公式サイト(AI PICKSの詳細)
- Claude:公式サイト(AI PICKSの詳細)
- ChatGPT:公式サイト(AI PICKSの詳細)
- Gemini:公式サイト(AI PICKSの詳細)
- ELYZA:公式サイト(AI PICKSの詳細)