Artificial Analysisの発表内容
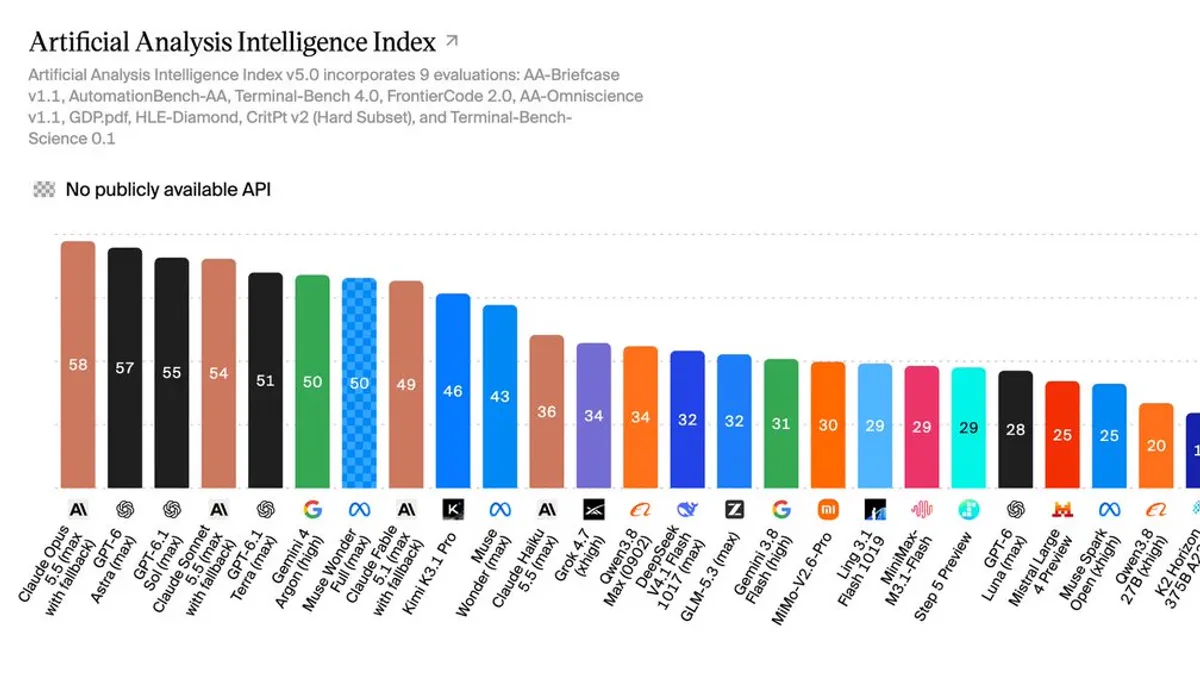
Artificial Analysisは2026年10月28日、AI総合指標「Intelligence Index v5」を発表しました。実務利用に即した能力を測るため、2つの新基準と3つの更新を導入しています。
今回の更新では、全体の60%が非公開の試験問題や解答をもとにした評価に切り替わりました。実務プログラミングを測る「FrontierCode 2.0」や、70の科学研究課題を扱う基準が加わっています。
測定結果では「Claude Opus 5.5」が58点で首位となりました。2位には「GPT-6 Astra」が57点で続きます。また、上位10モデルの間では、1課題あたりの処理費用に13倍以上の差が生じました。
利用者は、各モデルの最新の実務能力や運用コストの違いを客観的な数値で比較できます。用途や予算に合わせたAIモデルの選定に役立ちます。
つまり、どういうこと?
ざっくり言うと、AIの学力テストが「過去問の丸暗記」では通用しない新テストに変わりました。
評価に使われる問題の60%が非公開の問題集へ刷新されたため、見せかけではない本当の仕事の実力が分かります。
編集部の見方
筆者が驚いたのは、タスクあたりの処理費用に生じた大きな開きです。最安の「GPT-6.1 Terra」が0.96ドルの一方、「Claude Fable 5.1」は13.04ドルに達します。費用差は13倍以上。
一方、重み公開モデルと首位陣の点差が、従来の3点から12点へと開いた結果も気になります。公開済みの「DeepSeek V4.1 Flash 1017」は32点にとどまり、58点の首位とは26点差がつきました。さすがにこの差を見ると、自社運用より商用モデルの契約を急ぐ企業が増えそうです。
手軽さか、絶対的な性能か。次は重みが未公開の「Kimi K3.1 Pro」が正式提供された際に、この差をどこまで縮められるかを見届けたいところです。
誰に関係するか
実務向けのAIモデルを比較検討している人は、非公開テストに基づく実力やタスクごとの処理費用を確かめて導入を判断できるようになります。