HeyGenの発表内容
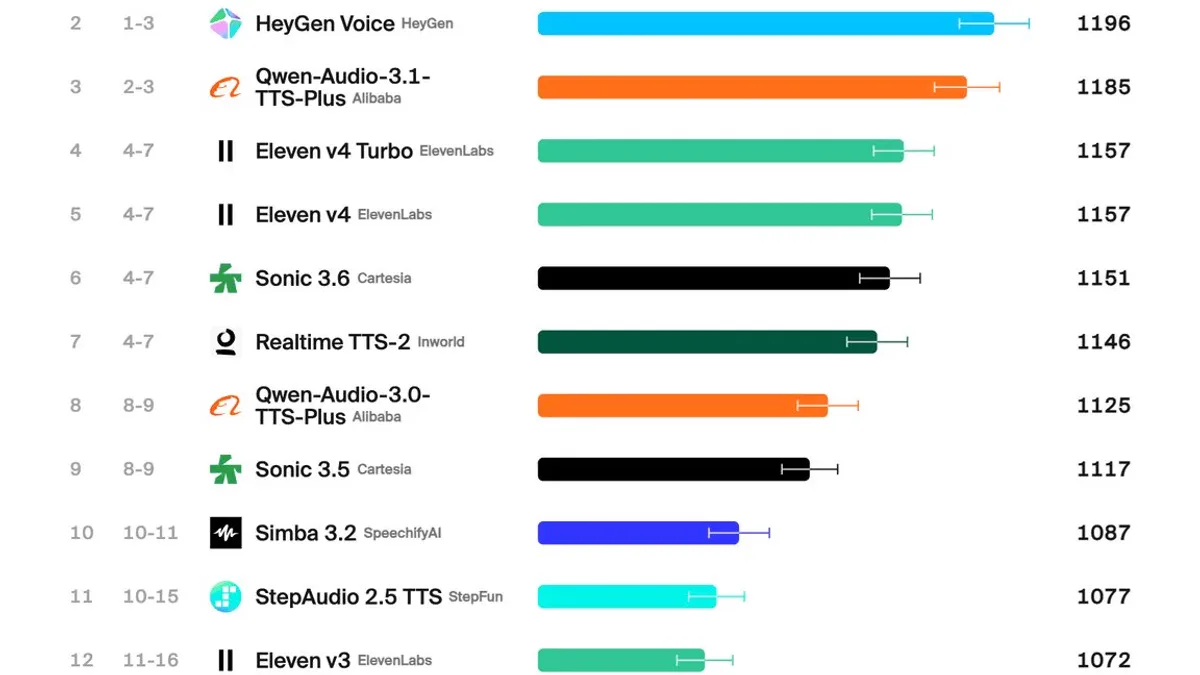
HeyGenは、アバター向けの新機能「HeyGen Voice STS」を発表しました。公式サイト上で動作を試せるテスト版の提供を開始しています。
従来のText-to-speech (文字を音声へ変換する機能) は、人が実際に話す抑揚とは差が生じていました。新機能のSTS (音声から音声を生成する技術) では、利用者が一度話した音声の演技全体をアバターへ引き継ぎます。
この機能を使うと、利用者が吹き込んだ言葉の細かな間や強調、ささやき声までアバターに反映できます。文字の入力だけでは難しかった話者の細かなニュアンスを残せます。
動画の案内役を作成している人は、自身が一度吹き込むだけで、感情や話し方の特徴を忠実に再現したアバター動画を作成できます。
つまり、どういうこと?
つまり、文字入力の代わりに自分の声をお手本として渡し、アバターに同じ調子でしゃべらせる仕組みです。
たとえるなら、アバターへの声当てです。文字を機械に読ませると平坦になりがちですが、自分が一度吹き込めば、息づかいや話すテンポをそっくりそのまま真似してくれます。
編集部の見方
テキストから作る音声は、どうしても機械っぽさが残ります。今回の発表を読んで、文章を打ち込む手軽さよりも、吹き込みによる再現度の高さを前に出してきた点に筆者は関心を持ちました。声の演技をそのまま渡すという発想は、かなり実用的です。
話し方の完コピ。
ただ、アバターの制作で一回でも録音の手間が挟まるなら、文字入力だけで完結させたい人には少し面倒かもしれません。まずは数本の動画で抑揚の違いを試してから、本格的に使うかどうかを決める形が良さそうです。
次は秋以降に各社から出る動画生成ツールの大型アップデートで、この音声同期がどこまで自然になるかを見届けたいところです。
誰に関係するか
HeyGenでアバター動画を作っている人は、吹き込んだ声の間や強弱をそのままアバターに反映できるようになります。
出典: HeyGen ↗