Cartesiaの発表内容
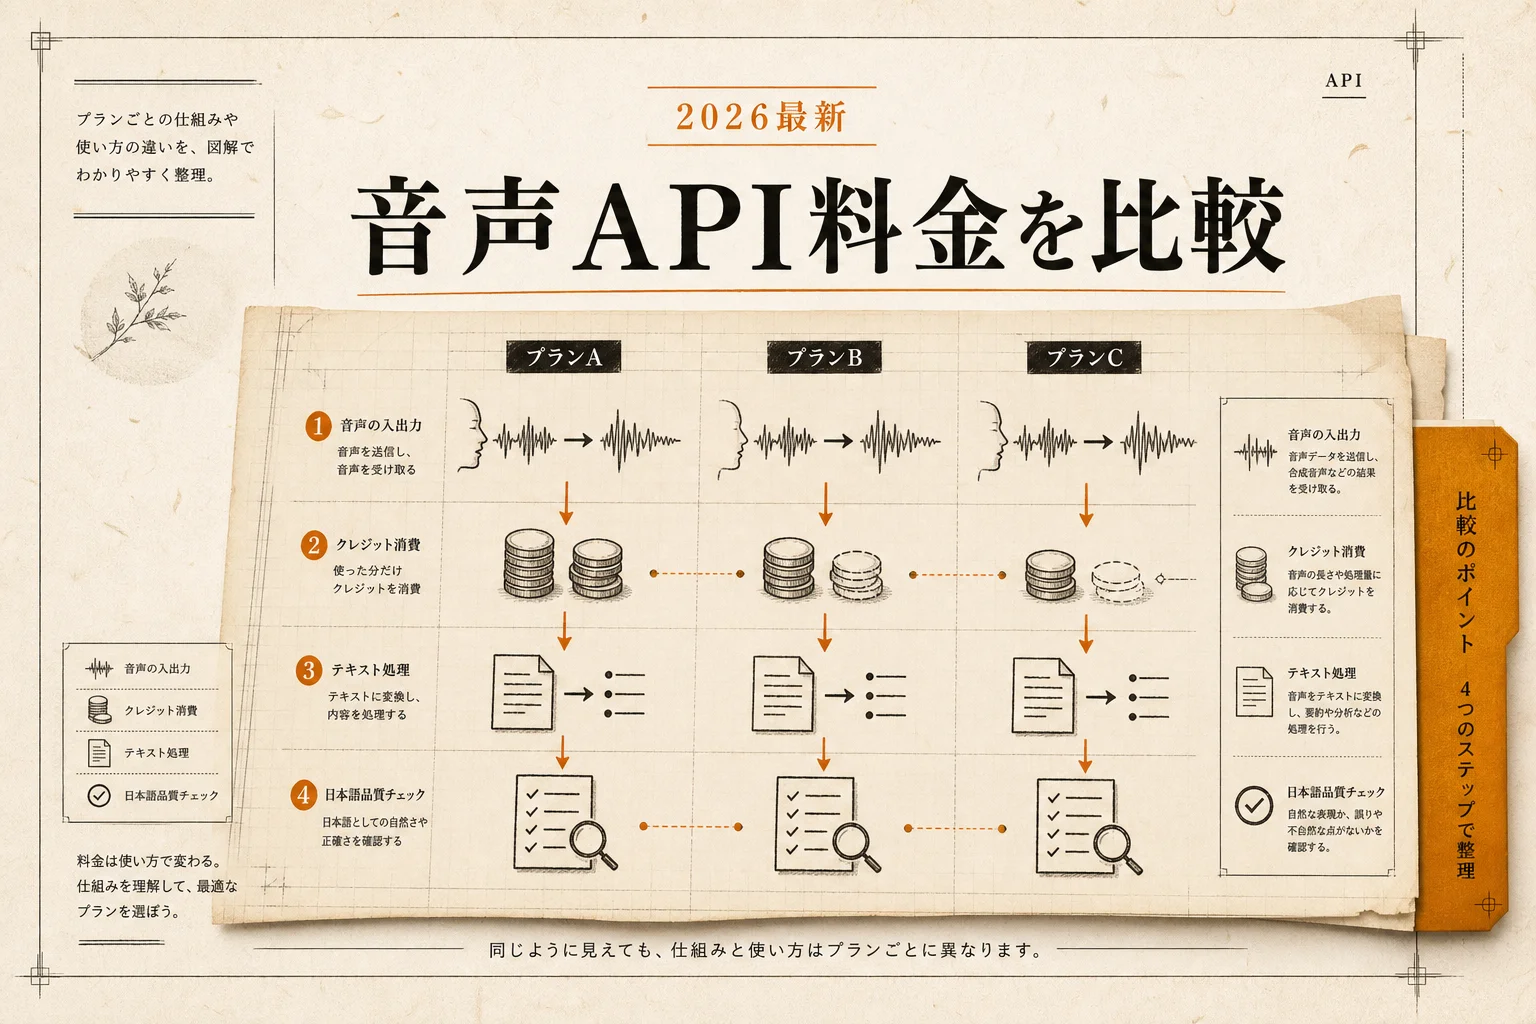
Cartesiaは、独自アーキテクチャを用いた音声AIモデル「Sonic」と「Ink」の技術構成を公開しました。AWSのインフラを活用し、100ミリ秒未満の低遅延で音声対話を行う仕組みを整えました。
音声合成モデル「Sonic」は、テキスト送信から約90ミリ秒で最初の音声を返します。44以上の言語に対応し、10秒の音声データから話者の声を再現できます。計算量が一定に収まるSSM (状態空間モデル) の採用で、文章が長くなっても処理速度を維持できる仕様です。
文字起こしモデル「Ink」は、利用者が話している最中に逐次テキストを出力します。文脈から相槌と発言の終了を判別するため、別の検知ツールなしで自然に会話を交代できます。周囲の雑音が多い環境や、複数人が同時に話す場面にも耐える設計です。
コールセンターや営業の自動応答、遠隔医療の対話システムにおいて、不自然な沈黙のない応答環境を整えられます。Amazon SageMaker AIやGPU搭載のEC2インスタンス上で動作し、開発チームはAPI経由ですぐに組み込めます。
つまり、どういうこと?
ひらたく言うと、AIが人間と同じ呼吸で会話できるようになる技術です。従来の音声AIは文全体を処理してから音声を生成していたため、不自然な間が空いていました。Cartesiaは発言を聞きながら同時に返答を準備し、100ミリ秒未満で声を出せます。まるで相槌のうまい受付担当者とテンポよくやり取りする感覚です。
編集部の見方
音声AIといえば声質のリアルさばかりが語られがちですが、Cartesiaが真っ先に応答速度を前面に出してきた点に、筆者はかなり納得しました。会話はテンポです。ここが少しでもずれると、人間は不自然さを感じてしまうからです。
ただ、10秒の音声から声を再現できる手軽さは、コールセンター業務を効率化したい企業にとって重宝しそうです。利用者が話し終わる前に文章の解釈を進める仕組みも、実務での実用性をよく考えて作られている印象を持ちました。
そこで気になるのが日本語への最適化です。
誰に関係するか
音声対話AIの開発や窓口業務の自動化を担当している人は、相手を待たせない自然な電話応答システムを構築できるようになります。