ZDR(Zero Data Retention)とは、生成AIのAPI処理において、送信したプロンプトや生成された回答データを事業者のサーバー内に一切保存せず、推論完了と同時に即時破棄する仕組みです。
社内規定や顧客との機密保持契約が壁となり、業務へのAI導入を足踏みしていませんか。
機密情報や個人情報を扱う企業にとって、AIベンダーのサーバーにデータが残るリスクは無視できません。ZDRの仕組み、導入時に確認すべき実務上の注意点を整理してお伝えします。
ZDR(Zero Data Retention)とは?AIサーバーにデータを保管させない基本原則
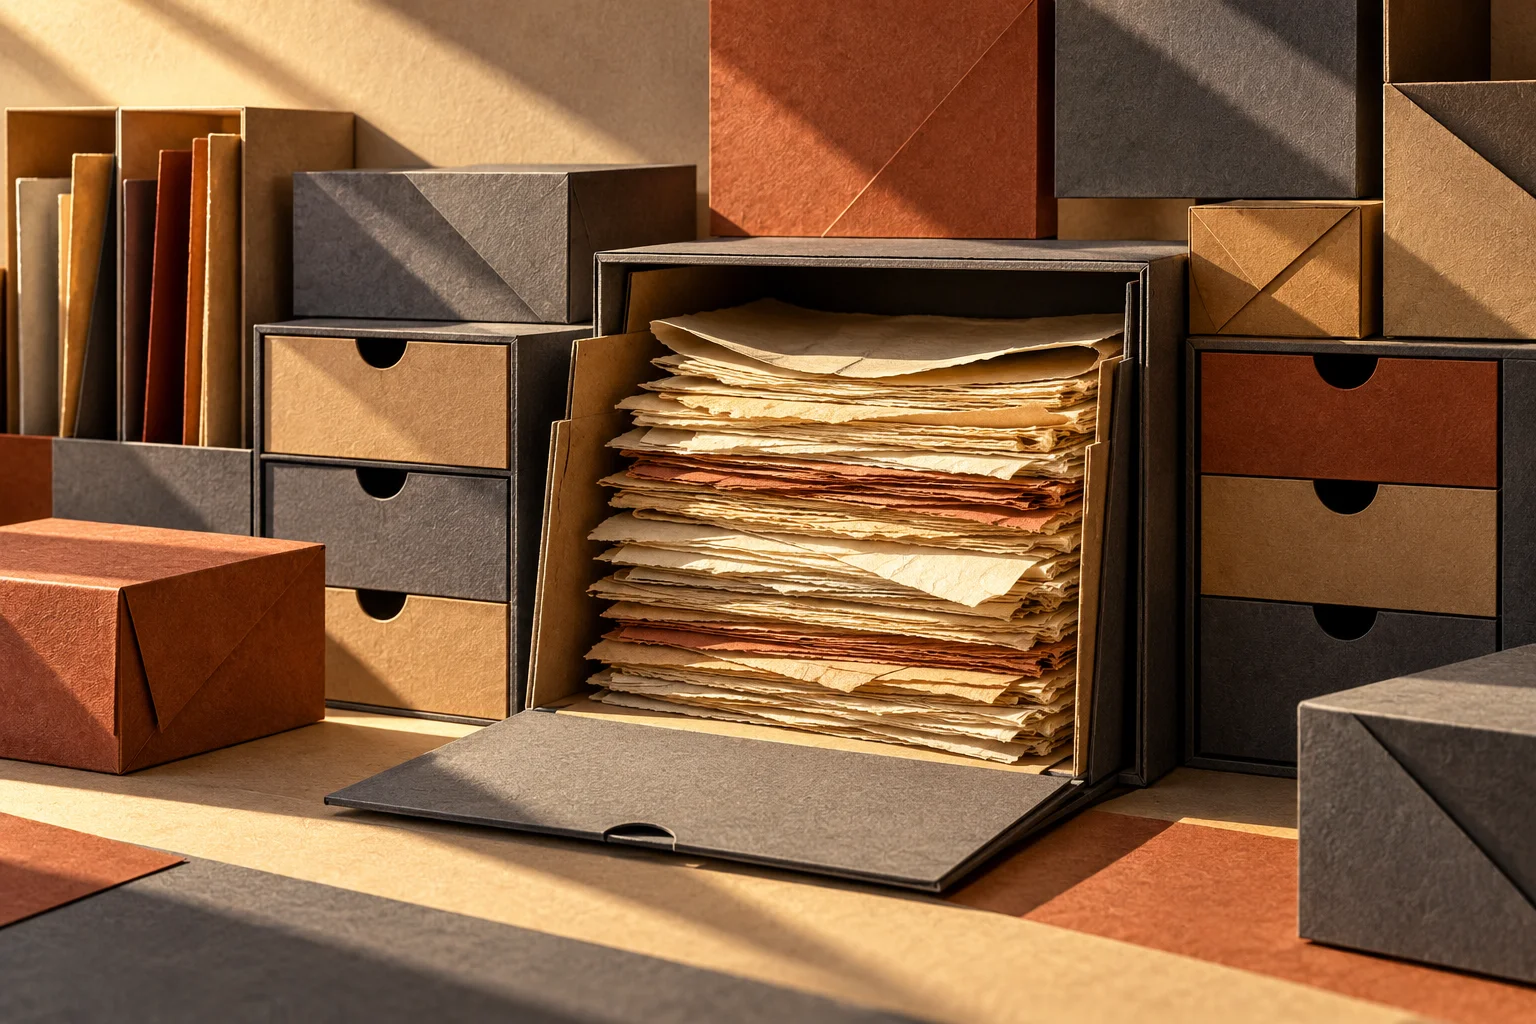
ZDRは推論処理に必要な瞬間だけメモリ上にデータを展開し、応答の返却とともに全データを消去する運用原則を指します。ディスクストレージへの書き込み自体をバイパスするため、ベンダーのシステム内に痕跡が残りません。
一般的なクラウドサービスでは、障害調査や不正検知を目的としてリクエストログを一定期間ストレージに記録します。AIモデルの提供企業も例外ではありません。通常の商用API契約では、プロンプトと応答内容が暗号化された状態で30日間程度サーバーに保管されます。
【一般的なAPIのデータフロー】
ユーザー入力 ──> [一時メモリ] ──> [AI推論] ──> 回答出力
                        │
                        └──> [ディスク書き込み] ──> 30日間ログ保管(不正監視用)

【ZDR適用時のデータフロー】
ユーザー入力 ──> [揮発性メモリのみ] ──> [AI推論] ──> 回答出力
                        │
                        └──> [即時消去] (ストレージへの永続化ログゼロ)
この保管期間を契約的・技術的にゼロ日へ変更する枠組みがZDRです。医療記録、金融取引データ、特許出願前の研究資料など、外部のディスクに1秒たりとも残せないデータを扱う現場で採用が進んでいます。
編集部のおすすめ
AIで
声で文章を入れる、写真を整える、資料を作る。よく使われる作業ごとに1本ずつ選んでいます。

通常の生成AI利用で発生するデータ保持リスク
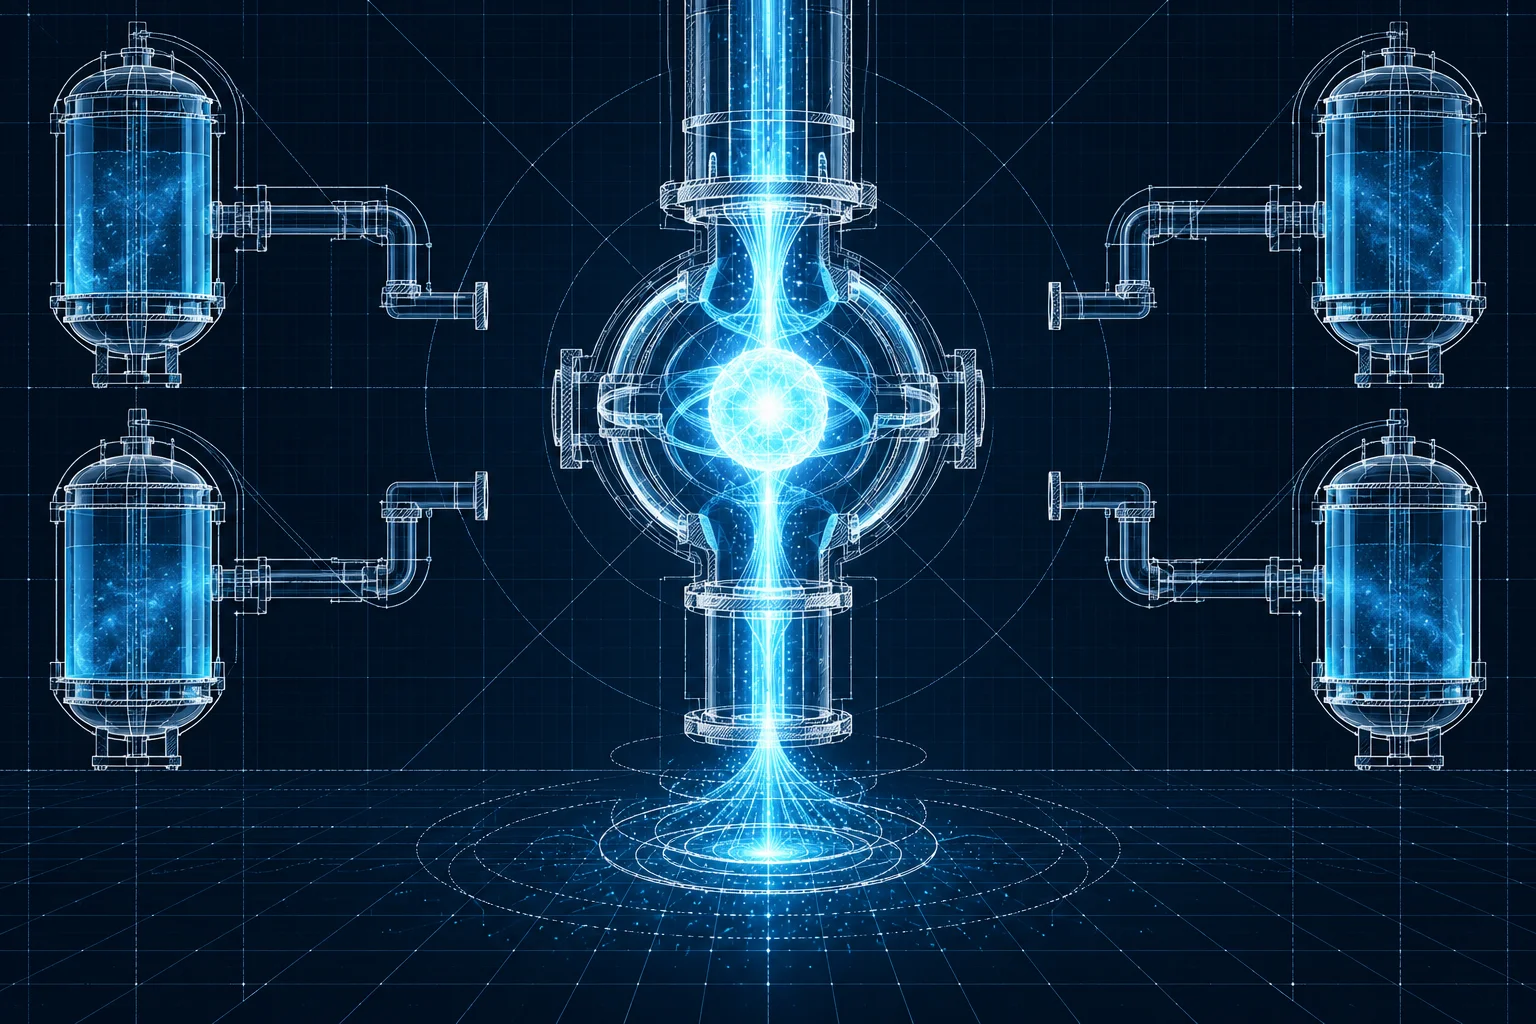
通常の契約形態では、学習にデータが使われない場合でも、不正利用の監視を理由に事業者の基盤へログが残ります。この一時保管ログがセキュリティ監査上の争点になります。
多くのAI事業者は、利用規約で「API経由の入力データをモデルの追加学習には使用しない」と定めています。学習に使われない点だけを見て安心しがちですが、実務上の危険は別の場所にあります。
不正利用の検知を目的とした30日間のログ保持です。
システムにログが記録されている期間は、仮に暗号化されていても外部攻撃や内部不正による漏洩リスクがゼロにはなりません。情報漏洩対策を統括する部署や法務部門から見れば、第三者の管理下にあるサーバーへ機密データを預けている事実に変わりないからです。自社のセキュリティ基準を満たすためには、学習の拒否だけでなく、ログ保管そのものの停止が求められます。
外部基盤との連携におけるリスク全般の評価基準は、zeta危険性は?注意すべきは個人情報・課金・年齢制限の3点でも詳しく整理しています。
ZDRはどのような仕組みでデータを消去するのか?
ZDRの基盤では、ユーザーから届いたテキストを揮発性メモリ(RAM)上のみで処理し、ストレージへの永続化を遮断します。処理プロセスが終了した瞬間にメモリ空間が解放され、物理的にデータが復元不能になります。
推論サーバーに届いたリクエストは、まずAPIゲートウェイを通過します。通常はこの段階で監査用ログパイプラインに入力内容が送信されますが、ZDRが有効化されたアカウントからの通信ではログパイプラインへのルーティングが切断されます。
リクエストデータはGPUまたは専用プロセッサの処理メモリに直接送られ、トークンの生成を実行します。
生成されたテキストがユーザー側のクライアントに送信し終えると、処理スレッドは終了します。保持されていた入力プロンプトと生成結果のキャッシュは即座にメモリから消去されます。ハードディスクやSSDなどの永続メディアにデータが一度も書き込まれないため、データの消し忘れやバックアップへの混入が発生しません。
次の表は、通常の商用API利用とZDR適用時におけるデータのライフサイクルを比較したものです。
| 項目 | 通常の | ZDR適用時 |
|---|---|---|
| 学習データへの利用 | なし(商用利用規約準拠) | 完全に対象外 |
| 推論時のメモリ展開 | 揮発性メモリで実行 | 揮発性メモリで実行 |
| ディスクへのログ記録 | あり(暗号化ストレージ) | なし(書き込み遮断) |
| 事業者側のデータ保持期間 | 原則30日間(不正監視目的) | 0日(推論完了と同時に消去) |
| 事業者スタッフによる閲覧 | 不正検知時のみ限定閲覧の可能性 | 閲覧不可(データが存在しない) |
| 法令開示要請への影響 | 過去30日分は対象になり得る | 過去ログが存在せず提出不可 |
このように、ZDRは「学習させない」状態からさらに進んで、「事業者の基盤に物理的なデータを残さない」状態を実現します。
高度なセキュリティ要件が求められるシステム構築では、データの保管場所を徹底的に管理する設計が欠かせません。AIエージェントの内部構造やデータの受け渡しを堅牢に保つ設計手法については、pstackとは?Cursorエージェントの開発精度を高める公式プラグインの中身と使い方が参考になります。
毎週月曜の朝に、今週のAIの主なニュース・新しく載ったツール・よく読まれた記事をまとめて届けます。登録特典は「AIツール選定チェックリスト 2026」。
確認メールのボタンを押すと登録が完了します。配信はいつでも解除できます。
ZDRとオプトアウト設定の違い
オプトアウトはモデルの学習データとして使われないようにする措置であり、ZDRは事業者のストレージにログを一切残さない措置です。
企業の現場で最も混同されやすいのが、学習の「オプトアウト」と「ZDR」の違いです。無料版のチャットAIなどで「設定画面から学習をオフにしたから安全」と判断するのは危険です。
学習をオフに設定した場合、送信したテキストが次世代モデルの訓練データに組み込まれる事態は防げます。
ただし、事業者のサーバーには不正利用の監視やデバッグのためにデータが一定期間保存され続けます。社外秘のソースコードや個人情報を入力した場合、保存期間中に事業者が侵害を受ければデータが流出する恐れを残します。
一方のZDRは、学習の対象外であることは前提としたうえで、監視用ログの保存そのものを拒絶します。「モデルの賢さに貢献させない」ための設定がオプトアウトであり、「他社のストレージに破片すら残さない」ための契約・アーキテクチャがZDRです。
二つの違いを正しく社内共有することが、AIガバナンス構築の第一歩です。
主要AIプロバイダーにおけるZDRの提供状況
OpenAIやAnthropicなどの主要プロバイダーは、エンタープライズ顧客向けにZDRの申請窓口と適用枠組みを用意しています。
個人向けの無料プランや月額課金の一般チャットサービスでは、ZDRは原則として適用されません。API経由の接続において、組織契約を結んでいる法人顧客向けに限定提供されるケースが主流です。
事業者の公式ドキュメントにおけるデータ保持方針の概要を整理しました。
| プロバイダー | 主力モデル群 | 標準の | ZDRの |
|---|---|---|---|
| OpenAI | GPT-6 Astra / GPT-6.1 Sol / GPT-6 Luna | 原則30日間(API) | 申請承認制(一定の利用実績または企業契約が必要) |
| Anthropic | Claude Opus 5.5 / Sonnet 5.5 / Haiku 5.5 | 原則30日間(API) | 申請承認制(法人向け契約でZDRポリシーを付与) |
| Google Cloud | Gemini 4 Argon / Gemini 3.8 Flash | Vertex AI標準でログ非保持設定可 | クラウド基盤側のアクセス制御により即時破棄を選択可能 |
上記のように、主要なAI基盤ではAPI経由を前提としたZDRの提供体制が整っています。
OpenAIのAPIでは長らく厳格な審査制によるZDRが運用されてきました。Anthropicも同様に、機密データを扱う法人顧客に対してデータ保持を無効化するオプションを用意しています。
Google CloudのVertex AI環境では、顧客がクラウドのセキュリティ境界内で管理できるため、ログ収集を明示的にオフにする運用が可能です。
企業がZDR導入時に確認すべき3つの注意点
ZDRを有効化するとデータの残存リスクを排除できる半面、システム運用と保守性において3つの明確な制約が発生します。
万全に見えるZDRですが、事前の設計なしに導入すると業務運用が破綻します。情報システム部門や開発チームが必ず確認すべきポイントは次の3点です。
1. 不正利用の調査・デバッグが極めて困難になる
事業者側にログが残らないため、API呼び出しエラーや出力結果の不具合が発生した際、相手側のログを調査材料として使えません。
通常のAPI利用であれば、不適切な出力やシステム例外が起きた際にベンダー側へリクエストIDを提示してサーバーログの突き合わせを依頼できます。ZDR環境ではベンダー側のデータが即座に消去されているため、「サーバー側で何が起きていたか」を問い合わせても回答が得られません。
自社側のログ基盤で、通信ヘッダーやレスポンスコードを適切に記録しておく設計が不可欠です。社内のログにも機密情報を書き込まないよう、マスキング処理を挟む工夫が求められます。
2. プロンプトキャッシュなど一部の高速化・省コスト機能が制限される
文脈をサーバー側に一時保存してレイテンシや費用を削るプロンプトキャッシュ機能は、データを保存しないZDRの思想と競合します。
長大な社内文書やマニュアルを頻繁に読み込ませるシステムでは、キャッシュ機能によるコスト削減が大きなメリットをもたらします。しかし、ZDRを厳格に適用するとプロンプトの断片をサーバーにキャッシュとして保持できなくなる場合があります。
結果として、リクエストごとにすべての文脈を最初から転送し直すことになり、応答待ち時間の増加やAPI利用料の上昇を招くトレードオフが存在します。
3. アプリケーション層や通信経路の脆弱性は防げない
ZDRが保証するのは「AIベンダーのサーバーにデータが残らないこと」だけであり、自社端末からAIサーバーに至る経路の安全性を担保するものではありません。
従業員のPCがマルウェアに感染していれば、入力途中のデータは盗まれます。自社が構築した中継サーバーの設定に不備があれば、そこからデータが流出します。ZDRの契約を結んだだけで「社内のAI利用がすべて安全になった」と誤認する事態が最も危険です。
次の表は、ZDR導入に伴う3大注意点と、企業側で講じるべき対策をまとめたものです。
| 注意点 | 発生する | 推奨される |
|---|---|---|
| デバッグ難度の上昇 | エラー発生時にベンダー側調査が不可能 | 自社の中継サーバーでメタデータと監査ログを厳密管理 |
| 機能・性能の制限 | キャッシュ無効化による遅延や費用の増加 | キャッシュ不要な短文処理から優先適用し費用対効果を試算 |
| セキュリティ範囲の誤解 | クライアント端末や中継地点での情報漏洩 | 通信経路の暗号化(TLS 1.3)と端末管理(EDR)の徹底 |
このように、ZDRは魔法の盾ではなく、自社のセキュリティ境界を正しく設定した上で機能する追加の防護策です。
AI活用時のデータガバナンスとコンプライアンス管理全般については、WIZZRとは?社会的責任調達(MVOI)管理ソフトの中身と選び方 (2026年版)でも企業の責任ある運用体制の考え方を取り上げています。
Private Safety Processing(PSP)とZDRの両立
悪質なプロンプトインジェクションや有害コンテンツの出力を防ぐセーフティ機構と、ZDRの完全なログ非保持は技術的な対立関係にあります。この課題を解消する技術がPSP(Private Safety Processing)です。
AI事業者は、モデルがサイバー攻撃のコード生成やテロリズムの支援に悪用される事態を防ぐ法的・倫理的責任を負っています。ログを完全に破棄してしまうと、悪意あるユーザーが重大な不正行為を繰り返した際に追跡ができません。
そこでOpenAIなどの先進プラットフォームでは、PSPと呼ばれる新しいアーキテクチャの導入が進んでいます。
【PSP(Private Safety Processing)の仕組み】
1. API呼び出し実行
2. 不正検知アルゴリズムが安全性を自動判定
3. 疑わしいフラグが立った通信のみを暗号化
4. 顧客自身のクラウドストレージ(AWS S3やAzure Blob等)に暗号化保存(30日間)
5. ベンダー側のサーバーにはデータを残さない
このアプローチにより、ベンダーの共有ストレージに機密データが保管される事態を回避できます。
企業は自社のセキュリティ基準を満たしながら、AI事業者のセーフティ要件をクリアできます。自社の管理下にある専用ストレージに暗号化された安全監査ログを退避させるため、第三者による不正アクセスから保護されます。
RAGや社内データ連携環境におけるZDRの適用範囲
社内文書を検索してAIに渡すRAG(検索拡張生成)システムでは、AI基盤だけでなくベクトルデータベース側のデータ保持にも注意を払う必要があります。
業務利用で主流となったRAG構成では、AIモデル単独でデータが完結しません。社内のファイルサーバー、検索エンジン、ベクトルデータベース、中継APIなど複数のコンポーネントを経由します。
AI事業者のAPIにZDRを適用しても、中継する社内サーバーや外部のベクトルデータベースに検索クエリの履歴が平文で保存されていれば、そこが情報漏洩の侵入口になります。
【RAG環境におけるデータ保持の管理ポイント】
[社内文書] ──> [ベクトル化処理] ──> [ベクトルDB](★ログ保持設定の確認)
                                         │ 検索結果
[社内ユーザー] ──> [中継サーバー] ─────────┼──────> [ZDR対応AIモデル]
                     (★通信ログ管理)                 (推論後即時消去)
AIモデルへのプロンプト投入だけでなく、検索処理のログ、埋め込みベクトル(Embedding)生成APIのデータ保持ポリシーまで一気通貫で「非保持」に設定しなければ意味がありません。
RAGの構造全体を見直してデータフローを保護する手法は、RAGとは?仕組み・ベクトルDB・最新動向まで完全解説 (2026年版)で体系的に解説しています。
ZDRを有効化する際の実務手順と運用管理
ZDRの適用はAPI管理コンソールからボタン1つで切り替えられる機能ではありません。事前の申請と利用実態の審査を経て有効化されます。
一般的な導入フローは以下の順序で進行します。
- 利用規模とユースケースの整理: 取り扱うデータの分類(個人情報、医療情報、金融機密など)と、想定される月間トークン消費量を明確化します。
- 公式ポータルまたは営業窓口からの申請: 事業者のエンタープライズ担当者または申請フォーム経由でZDRの適用を申請します。
- 組織IDおよびプロジェクトAPIキーの紐付け: 審査通過後、事業者の管理コンソール上で特定のプロジェクトIDに対してZDRフラグが付与されます。
- APIレスポンスのヘッダー確認: システム開発側でリクエストを送信し、返却されるレスポンスヘッダーにデータ非保持を示すフラグが含まれているかテストします。
- 定期的なステータス監視: APIの仕様変更やプロジェクトの再編によってZDR設定が解除されていないか、プログラムから定期的に確認を走らせます。
実務上よくある落とし穴が、新規プロジェクトを作成した際に「過去のAPIキーの設定が引き継がれている」と思い込んでしまうケースです。
ZDRはプロジェクト単位や組織単位で個別に適用されます。キーの再発行や開発環境の切り替え時には、必ずデータ保持ポリシーの適用状況を再点検する運用ルールを定めてください。
ワークフロー全体の自動化と安全なデータ連携については、Next Gen Zapsとは?MCP連携と自己修復で止まらないZapier自動化の仕組みでも実践的な連携管理を扱っています。
ZDRはどのような企業・用途で導入すべきか?
すべての企業にZDRが必須となるわけではありません。自社が取り扱う情報の機密レベルと、運用にかかる追加コストを天秤にかけて判断します。
Web上の公開情報を要約させたり、一般的なプログラミングの文法を質問したりする用途であれば、標準的な商用APIの規約(学習利用なし・30日ログ保持)で十分な安全性が確保されています。過剰なセキュリティ要件は、開発スピードを低下させる要因になりかねません。
ZDRの導入を強く推奨するケースは明確です。
- 医療機関・創薬研究: 患者の電子カルテデータや新薬の分子構造データを解析させる場合
- 金融機関・保険会社: 口座情報、与信審査データ、顧客の資産状況を扱う場合
- 士業・リーガルテック: 訴訟資料、未公開のM&A関連書類、知的財産出願書類を扱う場合
- 受託開発・SaaS事業者: 顧客から預かったデータをAIで処理し、契約上「第三者のサーバーへのログ残存」が固く禁じられている場合
これらの領域では、30日のログ保持すら重大な規約違反や法的リスクになり得ます。ビジネス要件としてZDRの適用が必須条件になります。
AI PICKS編集部の判定
自社で機密データを扱うシステムを開発する場合、主要モデルのZDR適用は今や必須の選択肢です。
かつては「AIを導入するか、セキュリティを守るか」の二者択一で議論されていました。現在では主要プロバイダーのAPIでZDRが整備され、機密性を保ったまま高性能な基盤モデルを組み込める環境が整っています。
判断として、顧客データを1件でも扱う法人サービスならZDRの申請は必須です。
一方で、社内FAQの作成や公開ドキュメントの翻訳といった一般的な用途にまでZDRを要求するのは、運用の負担が大きすぎます。キャッシュ無効化に伴うレイテンシの悪化や、エラー調査の難しさが現場の首を絞めるからです。
まずは扱うデータを機密区分で明確に分け、最重要データを処理するパイプラインにのみZDRを適用する設計が現実的で賢い落としどころです。
よくある質問(FAQ)
Q. ZDRを適用するとAIの回答精度は落ちますか?
推論の精度そのものは一切低下しません。
ZDRはデータの保存場所と保持期間を制御する設定であり、利用するAIモデルの重みパラメータや計算アルゴリズムを変更するものではないからです。同一のプロンプトを入力した場合、通常のAPIとZDR適用環境で生成される回答の質は変わりません。
Q. ChatGPTなどの一般チャット画面でもZDRは使えますか?
原則として利用できません。
一般向けのWebチャットUIは会話履歴の表示機能があるため、ブラウザ側およびサーバー側に対話データが保持されます。ZDRの対象は、法人向けに提供されるAPI経由の通信や、一部の特定エンタープライズ契約に限られます。
Q. 無料のAPIアカウントでもZDRを申請できますか?
原則として無料アカウントへのZDR適用は認められていません。
事業者が不正利用を監視できないリスクを負うため、本人確認の完了した企業アカウントや、一定額以上の利用実績がある組織アカウントに対してのみ審査のうえで提供されます。
Q. ZDRを有効にしているかどうかを確認する方法はありますか?
APIのエンドポイントを呼び出して取得するプロジェクト設定や、レスポンスヘッダーで確認できます。
各プロバイダーが提供するデータコントロールAPIを叩くことで、現在のAPIキーやプロジェクトが保持期間ゼロ(0 days)として構成されているかをプログラムから検証可能です。
Q. ZDRを使っていればGDPRや個人情報保護法を完全にクリアできますか?
ZDRの適用だけでは法令遵守の要件をすべて満たせません。
越境データ移転の制限や、個人情報を第三者基盤へ送信すること自体の同意取得など、法令ごとに異なる義務が存在するためです。データ保持をゼロにすることは安全性を高める有力な要素ですが、法務担当者による全体の処理フロー確認を省略できるわけではありません。
Q. 途中でZDRの設定を解除することは可能ですか?
管理コンソールまたはサポート窓口への連絡によって通常の保持ポリシーに戻せます。
ただし、解除した時点から送受信される新規データにのみ通常の保持期間が適用されます。ZDR適用中に処理されてすでに消去された過去データが復元されることはありません。
あわせて見たいツール・カテゴリ
セキュリティや自動化基盤を強化するうえで役立つ主要カテゴリと関連情報は以下の通りです。
自社のデータ保護方針が固まったら、社内検索やナレッジ管理の安全な構築に向けてRAGとは?仕組み・ベクトルDB・最新動向まで完全解説 (2026年版)をあわせて確認することをおすすめします。データ保持の境界線を正しく引く知識が深まります。
参考にした一次情報
記事の事実関係は、次の公式ページで確認しています。仕様や料金は変わることがあるため、最新の内容は各ページで確かめてください。
- OpenAI APIドキュメント「データ管理」(公式):不正利用監視ログは既定で最長30日保持され、ZDRは事前承認制で組織またはプロジェクト単位で選べます(2026年11月確認)
- Anthropic「組織データの保存期間」(公式):Anthropic APIの入出力は、ZDR契約などの例外を除き受信・生成から30日以内に自動削除されます(2026年11月確認)
- Anthropic「ZDR契約の適用対象製品」(公式):ZDRは承認制でClaude APIとEnterprise版Claude Codeの顧客向けに組織単位で適用されます(2026年11月確認)
- Claude Codeドキュメント「ZDR」(公式):Enterprise版Claude CodeのZDRでは、入出力の保存を要する一部機能が自動で無効になります(2026年11月確認)