Meta AIの発表内容
Metaは2026年10月20日に、巨大計算基盤「Prometheus」の第1期構築が完了したと発表しました。この設備を使い、Meta AIの新たな基盤モデル「Muse Wonder」を学習させました。
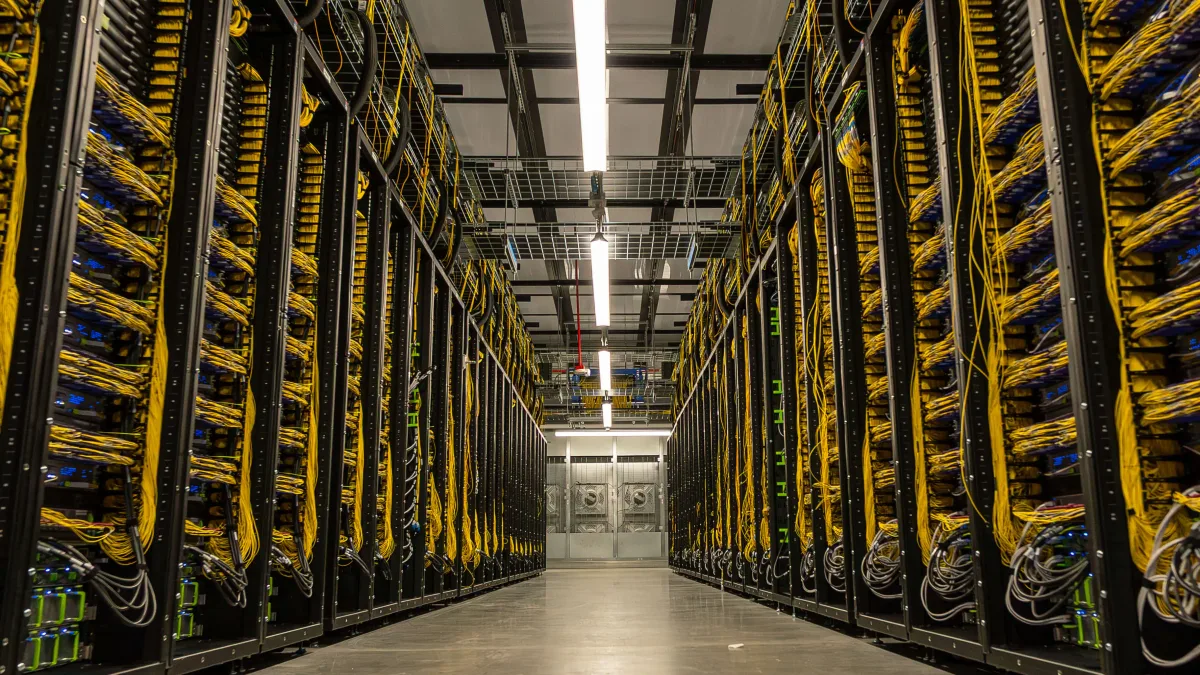
オハイオ州の施設にある数百棟規模の設備には、数十万基のGPU (画像処理半導体) が配置されています。事前学習では85%以上、強化学習 (試行錯誤で性能を高める手法) では90%以上の稼働効率を達成しました。
現在はNVIDIAの「GB200」などを導入しており、今後は約100万基の規模まで拡大する計画です。独自の冷却技術や配線設計を取り入れ、単一の巨大な計算機として連携して動作します。
個人や業務向けの自律的な処理において、高い処理能力を持つモデルが提供されます。基盤の規模拡大により、より長大な文章の処理や高度な作業への対応が進みます。
つまり、どういうこと?
ざっくり言うと、賢いAIを育てるための超巨大な専用工場が本格稼働したということです。たとえるなら、数十万台の高性能コンピューターを1本の太い線で束ね、1台の巨大な頭脳として動かしています。途中で止まる事故を減らし、無駄なく動き続ける環境を整えたことで、より賢いAIを効率よく作れる体制が整いました。
編集部の見方
GPUを数十万基並べても、1台の不具合で全体の作業が止まってしまうのが大規模学習の難しさです。その中で90%を超える稼働効率を維持したという数字に、筆者はかなり驚きました。力業ではなく、配線や冷却といった泥臭い設備設計の勝利です。
桁違いの投資規模。
ただ、将来的に約100万基まで増やすとなると、競合他社も同じ水準の設備投資を迫られそうです。自律型AIを業務に組み込みたい人なら、年内に登場予定とされる次世代GPU「GB300」の導入で、モデルの応答速度や精度がどれほど底上げされるかを見ておきたいところです。
誰に関係するか
日常業務で自律型AIを活用している人は、長大な文脈を扱った高度なタスク処理を任せられるようになります。
出典: go.meta.me ↗