業務システムへAIエージェントを組み込んだものの、数時間から数日におよぶ連続稼働で処理が止まり、頭を抱えていませんか。
Bedrock AgentCoreとは、Amazon Bedrock上で自律型AIエージェントを実行する際、メモリの即時解放とプロセスのコールドスタート抑制を両立させて長時間稼働を安定化させる専用ランタイム基盤です。複数のLLMや各種外部ツールを組み合わせる現場において、実行プロセスの肥大化を食い止める土台として導入が進んでいます。
従来のサーバーレス環境やコンテナ基盤では、タスクを跨いで状態を維持するエージェント特有のメモリ管理が困難でした。AgentCoreの導入により、インフラ障害に起因するタイムアウトやエラー落ちを最小限に抑えられます。本稿では、AgentCoreの仕組み、具体的なメリット、移行手順、コスト設計までを整理してお伝えします。
Bedrock AgentCoreとは何か?長時間自律稼働を支える新実行基盤の正体
AIエージェントが自律的に推論と行動を繰り返す環境では、従来のAPI呼び出し型システムとは異なる実行基盤が求められます。
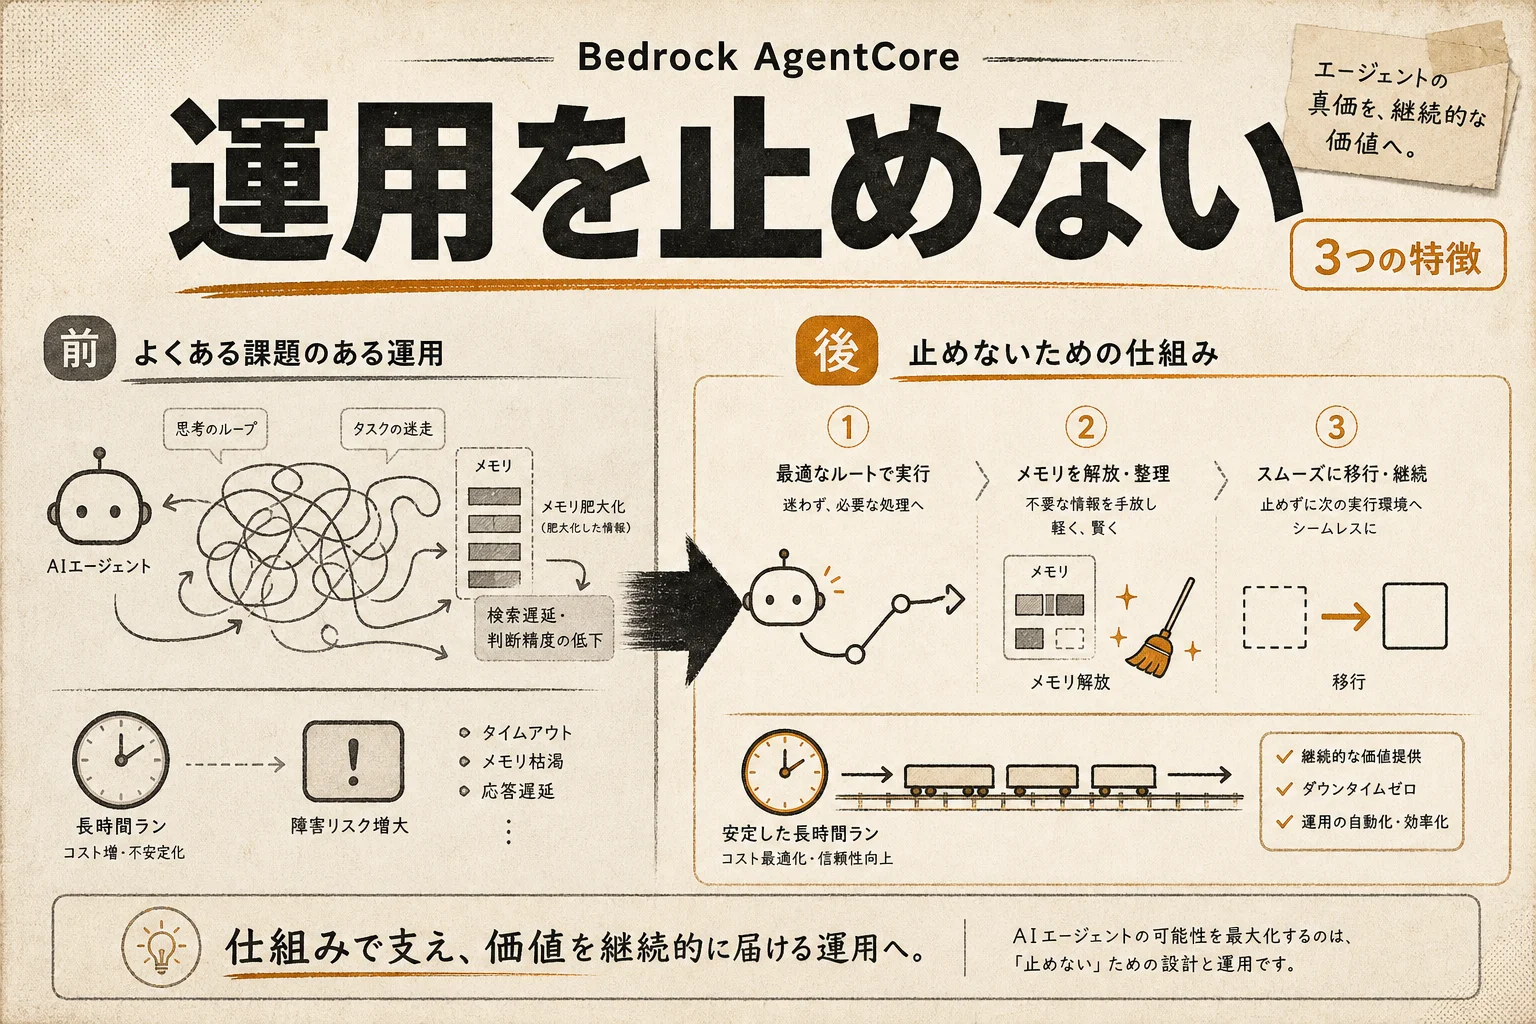
AIエージェントは、1回のリクエストで完結するチャットボットと異なり、思考プロセス、中間生成物、ツール呼び出し履歴などをメモリ上に保持し続けます。この状態保持が数時間に及ぶと、ランタイム内のメモリ領域が逼迫し、プロセスが突然強制終了するトラブルが頻発していました。
AgentCoreは、このエージェント特有の課題を解決するために作られた専用実行基盤です。タスク単位での隔離されたサンドボックス環境を提供しつつ、推論ステップごとに不要となった中間バッファを強制解放するガベージコレクション機構を備えています。
【従来の汎用実行基盤】
[推論ステップ1] → 状態保持
[推論ステップ2] → 状態保持 (メモリ蓄積)
[ツール呼び出し] → 外部I/O待機 (メモリ占有継続)
[推論ステップN] → メモリ枯渇・プロセス強制終了リスク大

【Bedrock AgentCore環境】
[推論ステップ1] → 差分スナップショット保存 → 即時メモリ回収
[推論ステップ2] → 軽量コンテキスト復元 → 即時メモリ回収
[ツール呼び出し] → 非同期待機中も最小メモリフットプリント維持
[推論ステップN] → 数十時間以上の連続タスクでも安定稼働
開発者はインフラ側のメモリリーク対策に追われることなく、エージェントのロジック構築に集中できます。クラウドネイティブなAI自動化基盤を検討しているなら、まずは/category/ai-agentに分類される最新ツールの動向も把握しておくと設計の幅が広がります。
なぜ今AgentCoreが必要とされるのか?従来エージェント基盤が抱えていた3つの限界
エージェント運用を本格化させた開発現場では、共通する運用トラブルが顕在化していました。
代表的な課題は次の3点に集約されます。
- メモリ蓄積によるプロセスの突然死: 反復ループや外部API呼び出しの戻り値がメモリを圧迫し、上限に達してクラッシュする事象。
- コールドスタートによるレイテンシ悪化: 待機状態から次の行動を開始する際、ランタイム起動に十数秒を要し、リアルタイム性が損なわれる問題。
- マルチモデル切り替え時のオーバーヘッド: 計画立案用モデルとコード実行用モデルを往復する際、コンテキストの受け渡しで通信遅延とメモリ重複が発生する負荷。
従来の汎用コンテナやサーバーレス関数は、ステートレスな短時間処理を前提に設計されています。長時間の文脈把握や動的なツールオーケストレーションを担うエージェントをそのまま載せるには、構造上の無理が生じていました。
AgentCoreは、エージェントのライフサイクルそのものに合わせたステート管理機構を内蔵しています。インフラの制約を意識せずに長大なワークフローを組める点が、多くのエンタープライズで歓迎されている理由です。
エージェント稼働を安定させるAgentCoreの3大特徴
AgentCoreが従来の実行環境と一線を画す理由は、エージェント運用に特化した3つのアーキテクチャ設計にあります。
1. メモリの即時解放と階層型キャッシュ
AgentCoreは、推論ステップが1回完了するたびに、作業メモリ領域を走査して不要な中間変数を破棄します。残すべき会話文脈や長期記憶は、ランタイム外の階層型キャッシュへ即座に退避される仕組みです。
この機構により、数百ステップにおよぶ複雑な調査タスクを実行しても、ランタイムのメモリ消費量は常に一定水準以下に保たれます。プロセスがメモリ不足(OOM)で突然死するリスクを根底から排除できる設計です。
2. 超高速なプロセス復元による待機コスト削減
外部APIのレスポンス待ちやユーザーの承認待ち(Human-in-the-Loop)が発生した際、AgentCoreは実行コンテナを休止状態へ退避させます。
イベントが再開すると、ミリ秒単位で元の実行状態を復元します。無駄なアイドル課金を防ぎながら、待機後の初回アクションがもたつくコールドスタートの弊害を抑え込むことが可能です。
3. 異種モデル間をつなぐゼロコピー・コンテキスト伝送
推論タスクごとに異なるモデルを使い分けるマルチモデル構成において、AgentCoreは共有メモリアドレスを介してプロンプトや文脈データを渡します。
モデルを跨ぐたびに発生していたデータのシリアライズ・デシリアライズ処理が不要となり、推論の切り替えオーバーヘッドが大幅に削減されます。大規模な推論基盤の構築については、社内インフラの統制を解説したCortexとは|内部開発者ポータルの使い方とBackstageとの違い (2026年版)でも共通する設計思想が取り上げられています。
従来ランタイムとAgentCoreの技術スペック比較
既存のAWS実行環境とAgentCoreの相違点を整理するため、仕様と挙動を比較表にまとめました。
次の表は、AWS Lambda、Amazon ECS、そしてBedrock AgentCoreにおけるエージェント実行特性の違いを示したものです。
| 項目 | AWS Lambda (従来) | Amazon ECS / Fargate | Bedrock AgentCore |
|---|---|---|---|
| 最大実行時間 | 15分(タイムアウト制限) | 無制限 | 実質無制限(ステート永続化) |
| メモリ解放タイミング | コンテナ破棄時のみ | アプリ側のGC依存 | 推論ステップ単位で即時強制解放 |
| コールドスタート時間 | 数秒〜十数秒 | 数十秒〜数分 | サブ秒(スナップショット復元) |
| 状態管理方式 | 外部DBへの都度書き込み | インメモリまたは外部KVS | ランタイム統合型ステートストア |
| モデル間連携 | JSONペイロード再送 | 内部ネットワーク通信 | ゼロコピー・コンテキスト共有 |
| 監視メトリクス | 基本メトリクス中心 | コンテナ単位のリソース監視 | エージェント思考ステップ単位の可視化 |
つまり、AgentCoreは「サーバーレスの手軽さ」と「常駐型コンテナの柔軟性」を兼ね備えつつ、エージェント特有のメモリ肥大化をランタイムレベルで防御する専用基盤です。
インフラ運用の手戻りを減らし、自律型ワークフローを安定稼働させたい現場において、有力な選択肢となります。
AgentCoreへの移行手順とコード書き換えの実務
既存のBedrock Agents環境や独自コンテナで動かしているエージェントをAgentCoreへ移行する手順を整理します。
作業は大きく分けて4つのステップで進行します。
ステップ1: エージェント定義のランタイム指定変更
AWS CDKやTerraform、またはAWS CLIで定義しているエージェント設定ファイル内の ExecutionRuntime 属性を書き換えます。
{
  "agentName": "CustomerSupportAgent",
  "foundationModel": "anthropic.claude-3-sonnet",
  "executionEngine": {
    "type": "AGENT_CORE",
    "configuration": {
      "memoryReclaimPolicy": "IMMEDIATE_STEP",
      "stateCacheTtl": 86400
    }
  }
}
従来の DEFAULT ランタイムから AGENT_CORE へ切り替えることで、新しいメモリ管理機構が有効化されます。
ステップ2: 状態保持ロジックの外部化コード除去
これまでアプリケーション側で泥臭く実装していた「メモリ不足対策のための定期スナップショット処理」をコードから削除します。
AgentCoreが自動でステップごとの状態を退避するため、コードベースが劇的に簡素化されます。自前のキャッシュクリーンアップ処理がAgentCoreのネイティブGCと衝突しないよう、手動のメモリ解放コードは原則として排除してください。
ステップ3: ツール定義(Action Group)の入出力スキーマ最適化
AgentCoreはストリーミング形式の入出力にネイティブ対応しています。Action Groupに紐づくLambda関数側のレスポンスを、一括返却からチャンク返却へ切り替えることで、待機レイテンシをさらに削ることが可能です。
ステップ4: ステージング環境でのループテスト
移行後の検証では、意図的に50回以上の思考ループを発生させるストレステストを実施します。メモリ消費グラフが階段状に右肩上がりにならず、ステップごとに基準値へ戻っているかをCloudWatchメトリクスで確認します。
エージェント開発環境の自動化やコード生成パイプラインの見直しには、Replit Agentの使い方・料金まとめ|Agent 3の新機能とBolt・Cursor比較 (2026年版)の知見も参考になります。
マルチモデル協調環境での挙動はどう変わるのか?
複数の専門モデルが対話しながらタスクを分担する「マルチエージェント協調」において、AgentCoreの恩恵は最大化されます。
タスクの振り分けを行うオーケストレーターモデル、推論を行う高性能モデル、軽量なサマリーモデルが混在する場合、従来の仕組みではモデルが切り替わるたびに巨大なプロンプト履歴全体をネットワーク経由で再送していました。
AgentCoreでは、コンテキストデータがランタイム内部の共有バッファに配置されます。各モデルはポインタを参照するだけで過去のやり取りを把握できるため、トークン転送に伴う通信遅延が発生しません。
【AgentCoreでのマルチモデル連携フロー】
[オーケストレーター] ──(タスク割り振りを指示)──┐
                                             │
                      [共有コンテキスト領域] ←┴─ ゼロコピー参照
                                             │
[コード生成モデル]   ──(コード生成と検証を実行)──┤
                                             │
                      [共有コンテキスト領域] ←┴─ 差分のみ更新
                                             │
[レビュー用モデル]   ──(最終判定を出力)─────────┘
このアーキテクチャにより、エージェント間の協調ステップ数が増加しても、全体の応答速度が劣化しにくくなります。外部サービスとの決済連携や自律的な資金移動を組み込むマルチエージェント基盤では、Coinbase for Agents代替7選無料・オープンソースのAIエージェント決済基盤 (2026年版)で紹介されているような分散環境の設計とも相性が良好です。
AgentCoreの料金体系とコスト最適化の判断基準
AgentCoreの利用料金は、従来のBedrock基底モデル呼び出し料に加え、専用ランタイムの実行リソースに応じた従量課金が発生します。
基底モデルのトークン従量課金とは別に、AgentCoreがアクティブに稼働している時間(ミリ秒単位)と、割り当てられたメモリ容量の積で計算されます。待機状態(外部ツール応答待ちなど)では実行プロセスの割り当てが解除されるため、アイドルコストは発生しません。
次の表は、月間10,000セッションを運用した場合の概算コストと、構成別の特徴を比較したものです。
| 運用構成 | 月額想定コスト感 | 主なコスト内訳 | メリット・留意点 |
|---|---|---|---|
| 従来Lambda + Bedrock | 安価(小規模向き) | APIトークン料+ Lambda実行料 | 15分超のタスク不可、自前管理コスト大 |
| 常駐ECS Fargate + Bedrock | 中〜高(固定費寄り) | Fargate常駐コンテナ費+トークン料 | アイドル時も費用発生、冗長化の維持費 |
| Bedrock AgentCore | 最適化(従量制) | アクティブ実行時間+トークン料 | 長時間稼働対応、待機中課金なしで無駄が最小 |
つまり、短時間の単純なタスクであれば従来のLambda構成で十分ですが、実行時間が読めない長時間タスクや待機時間の長い複雑なフローでは、AgentCoreに軍配が上がります。
ノーコードツールと組み合わせた社内業務の自動化であれば、Bubble vs kintone AI: 違いと選び方完全ガイド2026で触れられているような業務アプリ連携の観点からも、サーバーレス従量課金のAgentCoreがトータルコストを抑えやすい選択肢となります。
導入時に直面しやすい落とし穴と回避策
AgentCoreは強力な実行基盤ですが、特性を理解せずに導入すると予期せぬ挙動に悩まされる場面があります。
現場で起こりやすい典型的なトラブルと、その具体的な回避策を整理しました。
次の表は、AgentCore移行時に発生しがちなトラブルと推奨される対処法をまとめたものです。
| トラブル事象 | 主な発生原因 | 推奨される回避策 |
|---|---|---|
| 必要な文脈が消失する | メモリ即時解放のポリシーが厳格すぎる | 保存すべき状態変数を明示的に永続化指定する |
| ツールの並列実行エラー | アクション実行の依存関係定義ミス | ツール定義スキーマで非同期並列フラグを調整する |
| セッション復元遅延 | 巨大なバイナリデータを状態に含めている | ファイル実体はS3に退避しURIのみを状態に持たせる |
| APIコストの急増 | ループ終了条件の不備による過剰推論 | 最大ステップ数のハードリミットを必ず設定する |
つまり、AgentCoreの強みである「自動メモリ回収」を過信せず、アプリケーション層で「何を長期記憶に残し、何を捨てるか」の境界線を意識して設計することが重要です。
音声対話などリアルタイム性が極めて高いエージェント基盤を組む場合は、Grok Voice Agent Builderとは?1分0.08ドルで作る音声エージェントの使い方と料金のような専用基盤とのレイテンシ特性の比較も欠かせません。
あわせて見たいツール・カテゴリ
AIエージェントの構築や運用自動化を進める上で、あわせてチェックしておきたい関連領域のリンクをまとめました。
- /category/ai-agent: 最新の自律型AIエージェントやオーケストレーションフレームワークの動向
- /category/ai-automation: 業務プロセスの自律化・ワークフロー自動化ツール全般
- /ranking/ai-coding: コード生成やデバッグ作業を支援する先進開発ツールの実力比較
- /category/ai-customer-support: エージェント技術を応用した次世代カスタマーサポート基盤
- /category/ai-productivity: チームの作業効率と情報共有を最大化するAIソリューション
AI PICKS編集部の判定
Bedrock AgentCoreは、長時間の自律推論を本番環境で運用するエンタープライズにとって、現時点で「一択」と言える完成度を誇る実行基盤です。
従来のコンテナ運用でエンジニアを苦しめていたメモリリークの監視や、コールドスタート対策の泥臭いチューニングから解放される価値は圧倒的です。推論ステップ単位でメモリを即時回収するアーキテクチャは、エージェントインフラの標準仕様になり得るスマートさを備えています。
単発のQ&Aボットや数ステップで終わる簡易ワークフローに適用するのは、正直オーバースペックで微妙です。固定のコンテナ基盤を維持するコストを考えれば従量課金は破格ですが、数分で完結するタスクであれば既存のLambda環境で十分目的を果たせます。
数十ステップに及ぶリサーチ業務、自律的なコード修正ループ、システム横断のデータ収集など、「途中で落ちたら致命的」な重いワークフローを抱えるチームには重宝します。まずは社内の重厚なバッチ型エージェントからAgentCoreへ切り替えてみる価値は十分にあります。
よくある質問(FAQ)
Q. Bedrock AgentCoreは既存のBedrock Agentsと何が違うのですか?
エージェントの思考ロジックを動かす「下回りの実行エンジン」が異なります。従来の実行環境では長時間のタスク実行時にメモリが蓄積しやすく、外部連携の待機中もリソースを消費していました。AgentCoreは推論ステップごとのメモリ即時回収やサブ秒でのステート復元に対応しており、より長時間の自律稼働を安定して支えられます。
Q. 移行にあたってプロンプトやモデル定義の作り直しは必要ですか?
プロンプトや基底モデルの設定を根本から作り直す必要はありません。AgentCoreは既存のBedrock Agentsと高い後方互換性を持っています。主にインフラ側のランタイム指定と、Action Groupとのデータ受け渡し部分の設定変更のみで移行可能です。
Q. Claude以外のモデルでもAgentCoreの恩恵は受けられますか?
Bedrock上で提供されている主要な基底モデル全般で機能します。特にオーケストレーターと作業担当モデルを使い分けるマルチモデル構成において、ゼロコピーによるコンテキスト受け渡しが効くため、モデルの組み合わせを問わず高いスループットを発揮します。
Q. メモリ即時解放によって会話の文脈が途切れる心配はありませんか?
必要な対話履歴や長期記憶は専用のステートキャッシュへ自動退避されるため、文脈が失われる心配はありません。破棄されるのは推論途中の不要な一時変数やバッファ領域に限定されています。
Q. オンプレミス環境や他社クラウドからAgentCoreを利用できますか?
AgentCore自体はAWSのフルマネージドサービスであるため、実行環境をオンプレミスへ持ち出すことはできません。ただし、AWS SDKや公開APIを経由して、オンプレミスの社内システムや他社クラウドからエージェントを呼び出して実行指示を出すことは可能です。
次に読むならこれ: 自律型エージェントにWeb開発やコード修正を任せたい場合は、開発特化型ツールの最前線をまとめたReplit Agentの使い方・料金まとめ|Agent 3の新機能とBolt・Cursor比較 (2026年版)をあわせて確認すると理解が深まります。