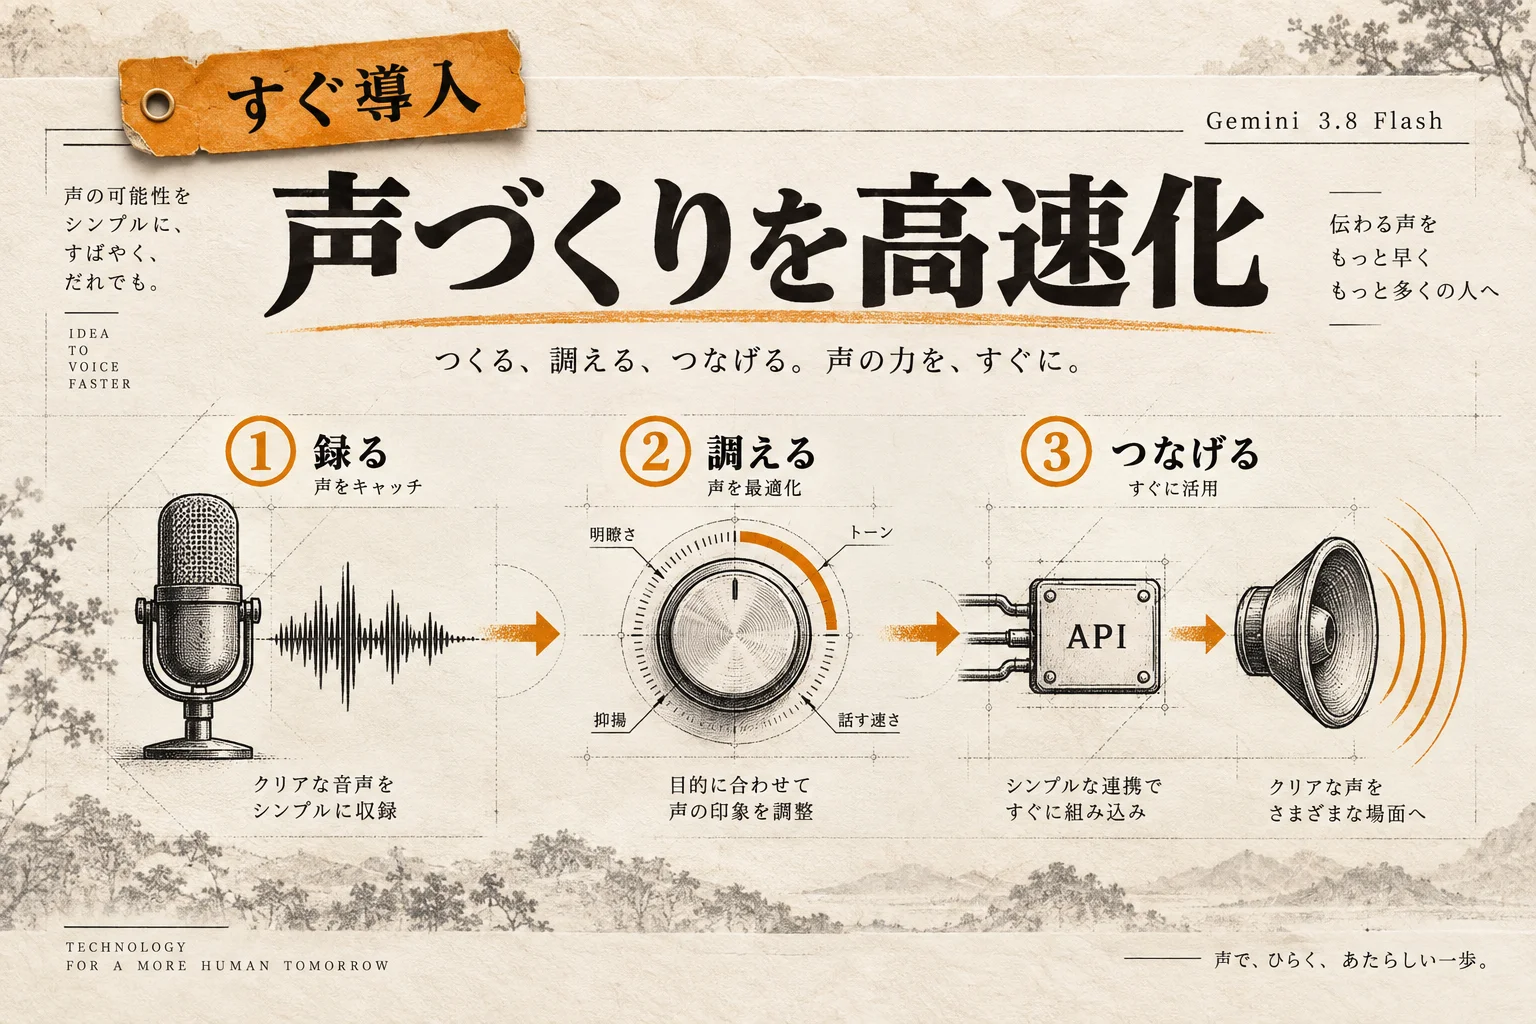

Gemini 3.8 Flash TTSを使うには、まずGoogle AI StudioでAPIキーを発行し、Pythonの公式SDK(google-genai)をインストールします。あとはgenerate_contentで音声出力を指定すれば、MP3やWAVの音声ファイルを書き出せます。
Gemini 3.8 Flash TTSとは、Google DeepMindが設計した高速処理と自然な発話を両立させたテキスト音声合成(Text-to-Speech)AIモデルです。従来の機械的な読み上げとは異なり、文脈のニュアンス、感情の揺らぎ、地域ごとのアクセントまで柔軟に再現します。
システムに自然な合成音声を組み込もうとすると、これまでは高額な従量課金や不自然なイントネーションに直面しました。その障壁を解消する選択肢が、このGemini 3.8 Flash TTSです。基本仕様から料金体系、APIの組み込み手順、独自アクセントの生成技術まで具体的に整理します。
Gemini 3.8 Flash TTSとは?従来の音声合成と何が違うのか
Gemini 3.8 Flash TTSの基本仕様と、従来のクラウド音声合成エンジンに対する技術的優位性を確認します。
Gemini 3.8 Flash TTSは、Gemini 3.8世代の推論速度と文脈理解力を受け継いだ音声合成特化システムです。従来のGoogle Cloud Text-to-Speechは、あらかじめ収録された音声素片を規則に基づいて繋ぎ合わせるアプローチが主流でした。そのため、語彙のアクセント辞書にない単語や、文脈に応じた細かな皮肉、感情の起伏を表現するにはSSML(音声合成マークアップ言語)の手動調整が欠かせませんでした。
対照的にGemini 3.8 Flash TTSは、100万トークンの広大なコンテキストウィンドウを処理できる基盤モデルの強みを活かします。入力された長文の文脈を先読みし、対話の流れに適した声色や話速を自動調整します。プロンプトによる声質指示も受け付けるため、「落ち着いた語り口のニュースキャスター風」や「親しみやすい関西弁混じりの案内音声」といった指示がそのまま音声出力に反映されます。
音声AIのトレンド全体を把握したい方は、Gemini 3.8 Liveとは?97言語の即時切り替えと並行作業を支えるGoogle音声AIの機能もあわせてご覧ください。
アーキテクチャの進化と低遅延設計
Gemini 3.8 Flash TTSの内部構造は、Flashアーキテクチャ特有のプルーニング(不要パラメータの削減)と蒸留技術によって徹底的に軽量化されています。この軽量化によって、音声ストリーミング生成における初声到達時間(Time to First Audio)が大幅に短縮されました。
通話自動化やリアルタイム翻訳など、会話のキャッチボールが発生する用途では1秒未満の応答性が求められます。従来の重厚な大規模マルチモーダルモデルでは音声生成に数秒のタイムラグが生じる場面がありました。Gemini 3.8 Flash TTSはこの遅延を解消し、インタラクティブなサービス運用に耐えうる速度を確保しています。

編集部のおすすめ
ChatGPT・
複数のAIに同じ質問をして答えを比べたり、講座で使い方を体系立てて学んだりできます。


初月10ドルオフ(新規ユーザー)
ChatGPTやClaudeへの長い指示を、打たずに声で入力できる。日本語にも対応し、Mac・Windowsのどのアプリでも使える(無料は1,000語まで)
AI音声・文字起こし / 最低料金 ¥0〜
Gemini 3.8 Flash TTSのAPI料金はいくらか?
開発環境および本番稼働におけるトークン単価と、2027年以降に予定されている改定スケジュールを整理します。
API利用の費用対効果を判断するために、Google公式が公開しているトークン単価の確認が必要です。Gemini 3.8 Flash TTSは2026年12月31日までの料金が設定されていて、2027年1月1日からは入力・出力とも2倍になります。
次の表は、Google公式の料金ページにあるGemini 3.8 Flash TTSのAPI利用料金(有料枠の標準単価)をまとめたものです。
| 期間 | 入力料金 | 出力料金 | キャッシュ入力料金 |
|---|---|---|---|
| 〜2026年12月31日 | 0.50ドル | 9.00ドル | 0.125ドル |
| 2027年1月1日〜 | 1.00ドル | 18.00ドル | 0.25ドル |
AI PICKS調べ: AIチャットボットカテゴリの有料プラン中央値は月2,249円(n=48、2026-11-08時点)。料金統計レポートで見る
従来の音声出力対応モデルであるGemini 3.1 Flash TTS Preview(出力100万トークンあたり20.00ドル)と比較すると、出力単価は55%下がっています。Batch処理ならさらに半額(入力0.25ドル・出力4.50ドル)です。
コストシミュレーション: 音声生成の文字数換算
トークン単価を実際の音声時間に換算すると、費用の実態が掴みやすくなります。Google公式の料金ページによると、音声は1秒あたり25トークンとして数えます。1時間の音声なら9万トークンです。
2026年12月31日までの出力単価(100万トークンあたり9.00ドル)で計算すると、1時間の完成音声を出力するコストはおよそ0.81ドル(1ドル=150円で約120円)です。1時間の日本語ポッドキャストの台本はおよそ15,000〜18,000文字なので、入力単価0.50ドルぶんの上乗せはわずかです。
月間1,000時間の音声を一括生成すると、出力だけで約810ドルになります。3.1 Flash TTS Previewの出力単価(20ドル)なら約1,800ドルかかる量なので、大量のオーディオブック作成や動画ナレーションの自動化では差がはっきり出ます。
課金枠や無料枠の詳細な比較基準は、Gemini 2.5の無料枠と料金|Pro・Flash・Flash-Liteの違い (2026年版)でも確認できます。
Gemini 3.8 Flash TTSは無料で使える?AI Studioと無料枠の注意点
Gemini 3.8 Flash TTSは、AI Studioの画面とAPIの無料枠なら無料で試せます。ただし、無料で送った台本はGoogleの製品改善に使われます。社外秘の原稿を入れる前に、ここだけは押さえてください。
2026年9月24日公開のQiitaの検証記事によれば、Flash TTSとFlash-Lite TTSはどちらも無料で使えたそうです。コードを書かずに声を聞きたいなら、AI Studioの画面から始めるのが一番の近道です。
| 使い方 | 料金 | 向いている |
|---|---|---|
| AI Studioの画面 | 無料 | まず声を聞いてみたい人 |
| APIの無料枠 | 無料 | 自分のアプリで試作したい人 |
| APIの有料枠 | 使った分だけ払う | 本番で大量に音声を作る人 |
試すだけならお金はかかりません。料金が発生するのは、有料枠に切り替えてからです。
有料枠の目安には、同じQiita記事が実際の請求トークンから計算した数字が役立ちます。音声1分あたり、Flashは約1.7セントでした。Flash-Liteは約1.2セントです。
ここが落とし穴。公式の料金表には、2026年12月31日までの単価が2027年1月1日から2倍になると書かれています。年をまたいで使う予算は、倍で見積もっておくのが安全です。
顧客情報や未発表の原稿は、無料枠に入れないこと。APIキーの発行からコードまでは、このあとの「APIの使い方」の節で順番に説明しています。
Gemini 3.8 Flash TTSが備える主な機能と強み
表現力と運用効率を向上させる4つのコア技術について解説します。
モデルの選定では、単なる安さだけでなく出力される音声の品質と運用上の柔軟性が問われます。Gemini 3.8 Flash TTSが評価されている理由は、単なる文字列の音素化を超えた制御能力にあります。
自然な抑揚と文脈追従
単文ごとの読み上げソフトでは、前後の文脈を無視した不自然な上がり調子や下がり調子が発生します。Gemini 3.8 Flash TTSは文脈全体の意味論を解析して音声を組み立てます。疑問文のニュアンス、感嘆の余韻、括弧書きの補足説明などを適切なピッチ変化で表現します。
独自アクセントと話者スタイルの制御
あらかじめ用意されたプリセット音声を選ぶだけでなく、システムプロンプトの記述によってアクセントを設計できます。「福岡地方の方言ニュアンスを微かに含んだ標準語」「英語の専門用語のみネイティブの発音に切り替える日本語」といった複雑な要望にも対応します。
大規模テキストの一括ストリーミング処理
100万トークンのコンテキストを保持できるため、長大なマニュアルや書籍1冊分を一度に渡し、整合性を保ったまま音声ストリーミングを受け取ることが可能です。章ごとに別ファイルを作成して後から結合する手間が省けます。
多言語間のシームレスな発音切り替え
日本語の文章中に英単語や中国語の固有名詞が混在していても、不自然な無音を挟まずに滑らかに発音をシフトします。海外ユーザー向けの観光案内や技術ドキュメントの読み上げにおいて、この多言語追従性は重宝します。
音声ツールのカテゴリ全体から適した技術を探したい場合は、/category/ai-voiceの分類一覧が役立ちます。
毎週月曜の朝に、今週のGeminiのニュースとアップデートを先頭に、AI全体の主なニュースと新しく載ったツールをまとめて届けます。登録特典は「AIツール選定チェックリスト 2026」。
確認メールのボタンを押すと登録が完了します。配信はいつでも解除できます。
従来モデルや競合音声AIとの性能比較
Gemini 3.8 Flash TTSと主要な音声生成モデルのスペックを比較し、用途ごとの立ち位置を明確にします。
音声合成の市場には、表現力重視のスタジオ向けモデルから、通信速度重視の通話向けエンジンまで多様な選択肢が存在します。用途に適した技術を選ぶため、主要項目を突き合わせます。
次の表は、Gemini 3.8 Flash TTSと先行モデルの主要仕様を比較したものです。
| 項目 | Gemini | Gemini | 一般的な |
|---|---|---|---|
| コンテキスト長 | 1Mトークン | 8.2Kトークン | 数千文字程度 |
| 推論エンジン | Gemini 3.8 Flash | Gemini 3.1 Flash | 音素辞書ベースDNN |
| 出力modalities | Audio / Text | Audio | Audioのみ |
| 出力単価(1Mトークン) | $9.00(2026年12月31日まで) | $20.00 | 100万文字あたり$16.00前後 |
| プロンプトによる声質指示 | 完全対応 | 限定的 | 非対応(SSMLタグ指定) |
| 推論遅延(初声到達) | 極めて短い | 普通 | 短い |
先行するGemini 3.1 Flash TTS Previewと比較して、コンテキスト長は8.2Kから1Mへと大幅に拡大し、出力単価は55%下がりました。
長文の構成力を保ちつつ低コストで大量運用する用途において、Gemini 3.8 Flash TTSは一択の選択肢となります。一方で、スタジオ品質の楽曲制作や微細な声優演技を完全再現する用途であれば、専用の音声生成ツールを適材適所で使い分ける判断が賢明です。
Flash TTSとFlash-Lite TTSはどちらを選ぶべきか
日本語のナレーションや人名を含む読み上げなら、Flash TTS一択です。電話の自動応答や大量の読み上げなら、安くて速いFlash-Lite TTSが合います。
AI StudioのDeveloper Guide(2026年9月23日公開)によれば、2つのモデルはAPIの形も指示文の書き方も同じです。モデル名をgemini-3.8-flash-ttsとgemini-3.8-flash-lite-ttsで入れ替えるだけで切り替えられます。両方で同じ台本を流して比べるのも手軽です。
| 比べる | Flash | Flash-Lite |
|---|---|---|
| 対応言語 | 130言語 | 101言語 |
| 音声出力の単価(100万トークン、2026年末まで) | 9ドル | 6ドル |
| 最初の音が届くまで(Qiita記事の計測) | 約1.8秒 | 約1.3秒 |
| 「東海林」など人名の読み | 正しく読めた | 読み間違えた |
| 向く用途 | 演技・2人の会話・方言・長いナレーション | 音声エージェント・問い合わせ対応・大量の吹き替え |
つまり、声の質で選ぶならFlash、速さと単価で選ぶならFlash-Liteです。入力テキストの単価は、どちらも100万トークンあたり0.50ドルでした(2026年10月時点の公式料金表)。
旧モデルgemini-3.1-flash-tts-previewを使っている人は、Googleの勧めどおりFlash-Liteへ移るのが無難です。モデル名を差し替えるだけで済みます。
リアルタイムで会話を返すところまで作りたいなら、Gemini 3.8 Liveの音声AIの解説を先に読むと設計の違いがつかめます。ほかの音声AIと比べたい人は音声AIランキングが早いです。
Gemini 3.8 Flash TTS APIの使い方: 環境構築と認証
Google Cloud環境またはGoogle AI Studioを活用し、APIキーの発行から開発環境の準備までを行う手順です。
APIの呼び出しを開始するには、Googleアカウントと有効なAPIキーの取得が必要です。開発用途であれば、Google AI Studioのコンソールから数分でキーを発行できます。
1. APIキーの取得手順
Google AI Studio(aistudio.google.com)にログインし、ダッシュボードからプロジェクトを作成します。「Get API key」を選択し、新規キーを生成します。
生成されたキーは外部に漏洩しないよう厳重に管理してください。環境変数としてローカルマシンに設定するのが安全な運用手順です。
# macOS / Linux の環境変数設定例
export GEMINI_API_KEY="AIzaSyYourGeneratedApiKeyHere"

# Windows PowerShell の環境変数設定例
$env:GEMINI_API_KEY="AIzaSyYourGeneratedApiKeyHere"
CLI経由のクイックな動作確認やテストを行いたい場合は、Gemini CLIの始め方|無料枠で1日1,000リクエスト・100万トークン (2026年版)の手順を併用すると検証時間を短縮できます。
2. クライアントライブラリのセットアップ
Googleが提供する公式SDKをインストールします。Python 3.10以上が導入された環境で、端末から次のコマンドを実行します。
pip install --upgrade google-genai
インストールが完了したら、SDKが正しく認識されているかを確認します。
import os
from google import genai

client = genai.Client(api_key=os.environ.get("GEMINI_API_KEY"))
print("SDK初期化完了")
エラーなく完了メッセージが出力されれば、スクリプトからGemini 3.8 Flash TTSを呼び出す準備は完了です。
Pythonコードによる基本的な音声生成スクリプト
テキストを入力し、音声バイナリを受信してWAVまたはMP3ファイルとしてローカルに書き出す最小限の実装例です。
Gemini 3.8 Flashはマルチモーダル出力に対応しており、モデルに対して音声出力(AUDIO)を指定してリクエストを送信します。
次のコードは、指定した日本語テキストを音声データとして保存する基本スクリプトです。
import os
from google import genai
from google.genai import types

# クライアント初期化
client = genai.Client(api_key=os.environ.get("GEMINI_API_KEY"))

prompt_text = "こんにちは。Gemini 3.8 Flash TTSによる音声合成テストを開始します。自然な発話が生成できているか確認してください。"

# 音声合成リクエスト
response = client.models.generate_content(
    model="gemini-3.8-flash",
    contents=prompt_text,
    config=types.GenerateContentConfig(
        response_mime_type="audio/mp3",
        system_instruction="あなたはプロのアナウンサーです。明瞭かつ落ち着いたトーンの日本語で発話してください。"
    ),
)

# 音声バイナリの保存
audio_data = response.candidates[0].content.parts[0].inline_data.data

with open("output_sample.mp3", "wb") as f:
    f.write(audio_data)

print("音声ファイル 'output_sample.mp3' の書き出しに成功しました。")
スクリプトの重要パラメータ解説
コード内のresponse_mime_typeにはaudio/mp3またはaudio/wavを指定します。帯域を節約してWeb配信に最適化する場合はMP3、編集ソフト等で後処理を行う場合は非圧縮のWAVを選択するのが通則です。
system_instructionの記述内容が声色のトーンを決定づけます。「誰が」「どのような場面で」話しているのかを明記することで、AIが最適な発話モデルを内部で選択します。
開発全般のツールやコーディング支援を強化したい方は、/category/ai-codingの情報も役立ちます。
独自アクセント・キャラクターボイスを作成する手順
プロンプトエンジニアリングを活用し、特定の方言やキャラクターの個性を音声に付与するテクニックを整理します。
Gemini 3.8 Flash TTSの最大の魅力は、追加の音声学習モデル(ファインチューニング)を構築することなく、指示文だけでアクセントや話し方をカスタマイズできる点です。
プロンプト設計の3大要素
独自音声の作成では、以下の3項目をプロンプトに盛り込みます。
- 話者の属性定義: 年齢、性別、職業、出身地
- 発話のテンポとトーン: 話速(bpm換算や感覚表現)、ピッチ、抑揚の大きさ
- 語尾や語彙のルール: 方言特有の語尾変化や口癖の指定
方言・地域アクセントの指定例
関西圏のイントネーションを再現したい場合の指示文サンプルです。
system_prompt = """
【話者設定】
・大阪出身の30代Webエンジニア
・親しみやすいトーンで同僚にアドバイスする口調
・基本は標準語ベースだが、語尾や助詞に自然な関西弁のイントネーションを含めること(例: 〜やね、〜してみてな)
・スピードは少し早め、テンポよく快活に話すこと
"""

response = client.models.generate_content(
    model="gemini-3.8-flash",
    contents="今回のシステム移行、思ったよりスムーズに進みそうやね。エラーログだけ先にチェックしておいてな。",
    config=types.GenerateContentConfig(
        response_mime_type="audio/mp3",
        system_instruction=system_prompt
    ),
)
英語混じりのビジネス発話
IT業界の技術解説などで生じる「カタカナ語と英語の発音ギャップ」を解消する設定です。
system_prompt = """
【話者設定】
・外資系IT企業のシニアコンサルタント
・落ち着いた低音のトーンで説得力を持たせる
・日本語の文法で話すが、「Kubernetes」「CI/CD」「Throughput」などの英単語は米語ネイティブの発音で発声すること
"""
このように具体的な条件を言語化して渡すことで、目的に合致した声質を素早く引き出せます。
リアルタイム音声ストリーミングと長文生成の実装パターン
Webサービスや電話応対システムへ組み込むための、チャンク分割受信とバッファリング制御の手法です。
長文の読み上げやチャットボットの音声出力では、全文の生成完了を待ってから音声を再生するとユーザーに待ち時間を与えてしまいます。ストリーミングAPIを活用し、生成された音声パケットから順次再生する仕組みを構築します。
次の図解は、クライアントとGemini API間の音声ストリーミングフローを示したものです。
sequenceDiagram
    autonumber
    actor User as エンドユーザー
    participant App as アプリケーションサーバー
    participant Gemini as Gemini 3.8 Flash TTS

    User->>App: テキスト送信 / 質問入力
    App->>Gemini: generate_content_stream (Audio要求)
    loop 音声チャンクの逐次返却
        Gemini-->>App: Audio Chunk (バイトデータ)
        App-->>User: ストリーミング音声再生
    end
    Note over User,Gemini: 初声到達まで数百ミリ秒で再生開始
Pythonによるストリーミング受信の実装例
import os
from google import genai
from google.genai import types

client = genai.Client(api_key=os.environ.get("GEMINI_API_KEY"))

long_text = """
大規模システムにおけるデータベースのシャーディング設計について解説します。
データ量の増加に伴い、単一インスタンスでの処理能力には物理的な限界が訪れます。
そこで検討されるのが、水平分割による負荷分散アプローチです。
"""

response_stream = client.models.generate_content_stream(
    model="gemini-3.8-flash",
    contents=long_text,
    config=types.GenerateContentConfig(
        response_mime_type="audio/mp3",
    ),
)

with open("streaming_output.mp3", "wb") as f:
    for chunk in response_stream:
        for part in chunk.candidates[0].content.parts:
            if part.inline_data:
                # 受信したバイトデータを順次書き込み(またはWebSocket等でクライアントへ転送)
                f.write(part.inline_data.data)
                print(".", end="", flush=True)

print("\nストリーミング受信が完了しました。")
この処理パターンをバックエンドに組み込めば、UI側でオーディオコンテキストを逐次デコードし、待ち時間を最小化したユーザー体験を構築できます。
他のGemini起動経路やアプリ全体の連携を確認したい場合は、Geminiの呼び出し方7通り|アプリ・Gmail・音声・APIの起動手順も参考になります。
実務で直面する課題とエラーへの対処法
API呼び出し時のレート制限、発音の誤読、不自然な間への具体的な解決策を整理します。
システムへGemini 3.8 Flash TTSを組み込んで商用運用する際には、運用特有の課題への事前対策が求められます。
1. 専門用語や人名の誤読
大規模言語モデルベースのTTSであっても、特殊な人名や専門略語の読み仮名を誤ることがあります。 この現象を防ぐ最も効果的な手法は、入力スクリプトの前処理です。
- 対策: スクリプト内の難読用語を「読み仮名(ひらがな/カタカナ)」に置換してからTTS APIへ渡します。
- 実装例: 「山崎(やまざき/やまさき)」など誤読が許されない固有名詞は、辞書テーブルを用意して事前展開します。
2. レートリミット(429 Too Many Requests)の制御
バッチ処理で大量の音声ファイルを生成する際、APIの同時リクエスト数上限に達してエラーが発生することがあります。
- 対策: 指数バックオフ(Exponential Backoff)を用いたリトライ機構をコードに実装します。Pythonの
tenacityライブラリなどを導入し、エラー発生時に待機時間を徐々に延ばしながら再試行する設計を徹底してください。
3. 文中の不自然な沈黙や区切り
テキストの句読点(、。)の配置によって、息継ぎの長さが意図しない間隔になる場合があります。
- 対策: 読点が多いと発話が途切れ途切れになります。1文あたりの文字数を40〜60文字程度に整え、意味のまとまりごとに改行を入れてプロンプトに渡すことで発話のリズムが安定します。
自動化パイプラインの構築や業務効率化ツールに関心のある方は、/category/ai-automationのツール群もあわせてチェックすることをおすすめします。
業務別の活用ユースケース
カスタマーサポート、教育コンテンツ、メディア配信での具体的な導入シナリオと導入効果を整理します。
Gemini 3.8 Flash TTSのコストパフォーマンスと表現力は、既存の音声業務を大きく刷新します。
次の表は、主な業務領域における導入ユースケースと得られる具体的な効果を整理したものです。
| 業務分野 | 具体的な | 導入に |
|---|---|---|
| カスタマーサポート | 電話自動応答(IVR)およびAIアバター対話 | 待ち時間の少ない低遅延発話と親しみやすい応対 |
| 教育・eラーニング | 教材テキストの多言語音声教材化 | 教材改訂時の再収録コストを完全ゼロ化 |
| メディア・出版 | ニュース記事やWebマガジンの音声版自動配信 | 記事公開と同時にポッドキャスト配信を自動開始 |
| 社内業務システム | 視覚障がい者向け業務マニュアルの自動読み上げ | アクセシビリティ基準の充足と情報伝達の均一化 |
大量の文字コンテンツを抱える組織ほど、従来の手動収録や高額TTSからの切り替えメリットが顕著に表れます。
社内サポートや顧客対応の自動化を進めるなら、/category/ai-customer-supportの最新ソリューションも比較候補に入ります。
AI PICKS編集部の判定
Gemini 3.8 Flash TTSに対する客観的な仕様比較と料金水準から導いた、本媒体の率直な評価です。
Gemini 3.8 Flash TTSは、大量のテキストを素早く自然な音声に変換したい開発者にとって、文句なしに破格の選択肢です。3.1 Flash TTS Previewで100万トークンあたり20ドルだった出力単価を、9.00ドルと半額以下に下げた点は大きな前進です。
プロンプトによる話者制御の自由度も高く、従来のSSMLタグを細かく打ち込む手作業から現場を解放してくれます。一方で、完全なスタジオ録音レベルの微細な感情演技や、ミリ秒単位の発声タイミング調整が求められるハイエンドな広告・アニメーション制作では、専用のクリエイター向け音声モデルに軍配が上がります。
Webメディアの自動朗読化、カスタマーサポートのボイスボット、教材の音声化といった実務領域においては、コストと品質のバランスで頭一つ抜けた存在です。導入を迷っているなら、優遇価格が設定されている2026年中に検証を済ませるのが得策です。
よくある質問(FAQ)
Gemini 3.8 Flash TTSの導入に関して寄せられる疑問点とその回答をまとめます。
Q. 生成された音声の商用利用は認められていますか?
商用利用は認められています。Google CloudおよびGoogle AI Studioの利用規約に準拠している限り、自社サービスの音声案内や販売コンテンツのナレーションとして利用できます。利用前に最新のGoogle利用規約およびAI原則の条項をご確認ください。
Q. 日本語の方言はどの程度正確に再現できますか?
関西弁や博多弁など、Web上のテキストデータが豊富な主要方言は高い精度で再現されます。ただし、語彙の言い回しだけでなく音調(イントネーション)を厳密に制御したい場合は、プロンプトにセリフの表記自体を方言に書き換えたテキストを渡し、話者設定で地域を明記する運用が確実です。
Q. Gemini 3.8 Flash TTSは無料で使えますか?
Google AI Studioの無料枠を利用することで、一定リクエスト数までは無料でテストが可能です。本番環境で大規模にAPIを呼び出す場合は従量課金プラン(Pay-as-you-go)の契約が必要となります。
Q. 音声の出力フォーマットは何が選べますか?
主にMP3およびWAV(リニアPCM)の指定が可能です。ストリーミング用途では軽量なMP3形式が選ばれるケースが多く、ローカルでの高音質編集やノイズ除去処理を行う場合はWAV形式での書き出しが推奨されます。
Q. 他のGoogle Cloud Text-to-Speechサービスとの違いは何ですか?
従来のCloud TTSは音素モデルに基づく確実な辞書発音が強みであり、Gemini 3.8 Flash TTSはLLMの文脈理解を活かした柔軟な感情表現とプロンプト制御が強みです。定型句の機械的な案内放送は従来型、ユーザーとの自然な対話や長文の情感豊かな朗読はGemini 3.8 Flash TTSが適しています。
Q. PCブラウザやアプリ上でそのまま音声を試すことはできますか?
Google AI StudioのWebコンソール上でプロンプトとテキストを入力し、音声出力を直接再生してテストできます。ローカルアプリでの利用感を確認したい場合は、Gemini Live PCの使い方|無料3手順60秒で起動・有料月¥2,900の差 (2026年版)も参考にしてください。
Q. 台本の中に「明るく言って」と書くとどうなりますか?
その指示まで読み上げられることがあります。3.8世代では、台本の欄は一字一句そのまま読む文章として扱われます。「明るく」「ささやく」などの演技指示は台本に混ぜず、別の場所に書くのが正しい使い方です。
Q. Gemini 3.8 Flash TTSの料金は2027年に変わりますか?
変わります。公式の料金表では、2026年12月31日までの単価が2027年1月1日からどちらのモデルも2倍になると書かれています。長く使う予定なら、いまの単価の倍で予算を組んでおくと安心です。
Q. 使える声の数はどれくらいですか?
Developer Guide(2026年9月23日公開)によれば、用意された声は30種類から2,000種類以上に増えました。笑い声や咳、ため息といった自然な間も、指示文で入れられます。気に入る声が無ければ、説明文から声を作るボイスデザインも使えます。
あわせて見たいツール・カテゴリ
音声合成やAI自動化の導入検討を深めるための関連リンクです。
- Gemini: Googleが提供するマルチモーダルAIモデルの詳細と機能一覧
- AI音声・文字起こしツール一覧: 最新の音声合成・音声認識ツールを比較
- AI音声ツールランキング: 人気の音声AIエンジンの機能と料金ランキング
- AIエージェントツール一覧: 音声対話を組み込める自律型AIエージェントの動向
- AIカスタマーサポートツール一覧: 音声自動応答(IVR)に最適なCS向けAIサービス
デスクトップ環境でGeminiの音声対話機能を体感したい場合は、次に読む記事としてGemini Live PCの使い方|無料3手順60秒で起動・有料月¥2,900の差 (2026年版)をおすすめします。PC単体での起動方法と実用的な活用手順が手短に分かります。
各ツールの公式サイト(一次情報)
料金・機能・対応範囲は各社公式が一次情報です。本記事は公開時点の検証に基づきますが、最新かつ正確な条件は必ず各公式ページで確認してください。
- Gemini:公式サイト(AI PICKSの詳細)