
画像生成AIで特定のキャラクターや絵柄を何度出力しても崩したくないときがあります。自社専用の業務マニュアルに沿った応答をチャットボットにさせたい要望も日常茶飯事です。市販のAIモデルをそのまま動かすだけでは、求める出力を得られません。
LoRAとは、巨大なAIモデル本体を書き換えずに、追加したい知識や画風の差分だけを小さな追加行列として低コストで学習させる技術です。
この技術を使えば、数千万円規模の計算設備を用意する必要はありません。手元のパソコンや安価なクラウドGPUで、AIの振る舞いを狙い通りに調整できます。
LoRAとは?巨大モデルを固定して差分だけを学ぶ仕組み
LoRAはベースモデルの計算層を凍結したまま、外付けの小さな計算層だけを追加学習させる仕組みです。巨大なモデル本体を作り直す無駄を省き、最小限のデータで新しい知識を定着させます。
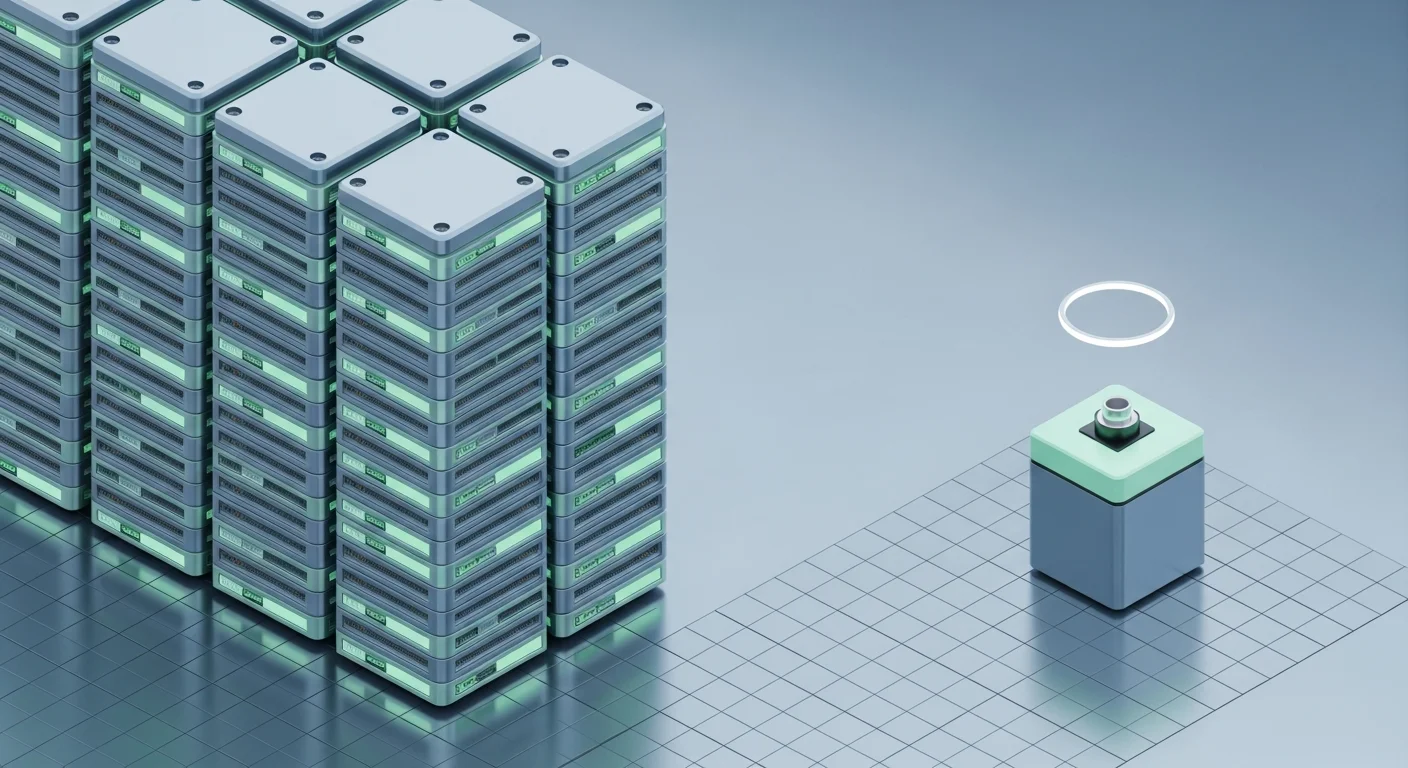
分厚い百科事典の改訂を想像してください。
事典の内容を全ページ書き直して再印刷すれば、莫大な印刷費用と製本の手間がかかります。
LoRAのアプローチは違います。事典のページには手を触れず、自分専用の透明な付箋を必要なページに挟み込みます。
挟み込んだ付箋にあたる差分データがLoRAファイルです。
ファイル容量を比べると、取り回しの良さは歴然です。
通常の画像生成モデル本体は2GBから7GBほどの容量を消費します。
LoRAファイルの容量は50MBから200MB程度で収まります。
手元のストレージをほとんど圧迫しません。
【ベースモデル(本体)】 2GB〜7GB(完全固定・読み取り専用)
          │
          ▼
   ┌──────────────┐
   │  元の計算処理 │ ──┐
   └──────────────┘   │
                      ├─▶ 【合算出力】(指定の絵柄や文体が反映)
   ┌──────────────┐   │
   │ LoRA追加行列 │ ──┘
   └──────────────┘
【LoRAファイル】 50MB〜200MB(ここだけを高速・低コスト学習)
この手法は2021年にMicrosoftの研究者が発表した論文から始まりました。
元々は大規模言語モデル(LLM)の微調整向けに提案された技術です。
オープンソースのAI画像生成ツールのコミュニティへ波及したことで一気に認知が広がりました。
現在ではテキスト生成と画像生成の双方で、標準的な調整手法として定着しています。
本体を壊さず、目的に応じて差し替えられる柔軟性が評価されています。
キャラクターごとの対話システムを構築したい場合、AIチャットボットの基礎知識を合わせて確認しておくと設計がスムーズです。
編集部のおすすめ
PCに
GPUや環境構築がなくても、登録してすぐブラウザで生成できます。多くは無料枠から試せます。
フルファインチューニングとLoRAの違いはどこにあるのか?
フルファインチューニングは全パラメータを書き換える手法であり、LoRAは全体の1%未満の差分層だけを更新する手法です。計算資源と保存容量の負担を劇的に削り落とせます。
従来のフル学習には運用上の大きな欠点がありました。
学習を終えるたびに、モデル全体を丸ごと保存し直す必要があります。
用途ごとにモデルを作ると、1つあたり数GBから数十GBの巨大ファイルがいくつも積み上がります。
保管場所が埋まるだけでなく、用途を切り替えるたびに巨大なファイルをメモリへ読み込まなければなりません。
学習にかかるサーバー費用も桁違いでした。
数十億のパラメータを持つモデルをフル学習するには、業務用の超高性能GPUを何日も動かし続ける必要があります。
大企業の研究機関でなければ手が出ない世界でした。
主要な運用項目の違いを整理しました。
| 比較項目 | フルファインチューニング | LoRA |
|---|---|---|
| 更新パラメータ割合 | 100% | 0.1%〜1.0%未満 |
| 必要GPUメモリ(7B〜8Bモデル) | 80GB以上(A100/H100推奨) | 16GB〜24GB(民生用GPUで動作) |
| 学習後のファイル容量 | 15GB〜30GB前後 | 50MB〜200MB前後 |
| モデル切り替えの速さ | 再読み込みに数十秒 | 即座に切り替え可能 |
つまり、LoRAは計算資源の消費とファイル容量の膨張を同時に抑え込む現実的な選択肢です。
実用上の性能差はごくわずかしかありません。
調査会社の検証データによると、LoRAはフル学習の約10分の1の費用で同等の出力品質を達成しています。
社内文書への適応や画風の固定であれば、フル学習を選ぶ理由はほとんどありません。
手軽に微調整を行いたい用途では、LoRAが一択です。
自社の文章作成ルールをAIに学習させたい場合は、AIライティングの動向もあわせて確認しておくと応用範囲が広がります。
LoRAの数学的アプローチと低ランク分解の基本
LoRAの中核は、巨大な重み更新行列を2つの小さな低ランク行列の積に分解する数学的工夫にあります。パラメータ数を大幅に削りながら、元の表現力を損なわない情報圧縮を達成しています。
AIの学習は、重みと呼ばれる無数の数値を書き換える処理です。
元の重み行列を$W$と置きます。
追加学習による重みの変化量を$\Delta W$と表します。
フル学習では、この$\Delta W$の全数値を直接計算して更新します。
元の行列が4096×4096のサイズだった場合、要素数は約1677万個に達します。
この計算を繰り返すと、膨大なメモリを消費します。
開発チームは、追加学習で変化する情報の次元が実際にはごく小さい点に着目しました。
数学的には「固有ランクが低い」状態を指します。
変化量$\Delta W$を2つの細長い行列$A$と$B$の掛け算で表現します。
$$\Delta W = B \times A$$
ランク$r$を8に設定した場合を考えてみます。
行列$B$のサイズは4096×8(約3.2万パラメータ)です。
行列$A$のサイズは8×4096(約3.2万パラメータ)となります。
合計のパラメータ数は約6.5万個です。
元の1677万個から、およそ250分の1にまで計算対象を圧縮できます。
【従来の更新 ΔW】
┌─────────────────────────┐
│                         │
│  4096 × 4096 行列       │ = 16,777,216 パラメータ(メモリ消費大)
│                         │
└─────────────────────────┘

【LoRAの低ランク分解 B × A】
┌──────┐
│  B   │   ┌─────────────────────────┐
│ 4096 │ × │        A (8 × 4096)      │ = 65,536 パラメータ(大幅削減)
│  ×8  │   └─────────────────────────┘
└──────┘
初期状態では、行列$A$をガウス分布のランダム値で満たし、行列$B$をすべて0で初期化します。
積である$B \times A$は最初完全に0です。
学習前のモデル出力には一切ノイズが入りません。
学習が進むにつれて、$B$と$A$の積が徐々に必要な差分を形成していきます。
この仕組みにより、既存の知識を壊さずに新しいパターンだけを効率よく吸収できます。
学習の自動化パイプラインを組む際は、AIコーディング支援を活用すると環境構築のコード作成を短縮できます。
毎週月曜の朝に、今週のAIの主なニュース・新しく載ったツール・よく読まれた記事をまとめて届けます。登録特典は「AIツール選定チェックリスト 2026」。
確認メールのボタンを押すと登録が完了します。配信はいつでも解除できます。
画像生成とLLMにおけるLoRAの主な使い分け
LoRAは画像生成と大規模言語モデルの双方で広く使われていますが、適応させる層や狙いは大きく異なります。目的に応じた使い分けを理解しておく必要があります。
画像生成AIでは、主にStable DiffusionやFLUX.1などの拡散モデルに適用します。
モデル内部のU-NetやDiT(Diffusion Transformer)に含まれる交差注意(Cross-Attention)層へ差分を差し込みます。
学習させる対象は、特定のキャラクター、特定のイラストレーターの画風、特定の衣装やポーズです。
15枚から30枚程度の高品質な画像を用意すれば、十分な精度のLoRAを作成できます。
複数のLoRAを同時に読み込み、適用強度を0.0から1.0の間で細かく調整できる点も特徴です。
言語モデルでは、LlamaやMistral、Qwenなどの基盤モデルに適用します。
自己注意(Self-Attention)機構の重み行列($W_q$, $W_k$, $W_v$, $W_o$)や、フィードフォワード層へLoRAを適用します。
学習させる対象は、業界専門用語の応答パターン、社内文書のフォーマット、特定のトーンアンドマナーです。
数百件から数千件の対話データセットを用意して学習させます。
用途ごとの特徴と推奨設定を比較表にまとめました。
| 用途 | 主な | 必要データ量 | 推奨ランク |
|---|---|---|---|
| 画像: キャラクター固定 | 特定の人物・髪型・衣装 | 画像15〜30枚 | 16〜64 |
| 画像: 画風・背景スタイル | 色使い・筆致・背景の質感 | 画像30〜100枚 | 32〜128 |
| 言語: 応答トーン調整 | 敬語表現・社内規定フォーマット | テキスト500〜2,000件 | 8〜16 |
| 言語: 専門知識の定着 | 医療・法律・金融の独自用語 | テキスト3,000〜10,000件 | 32〜64 |
つまり、画像生成では少数の画像から特徴を抽出し、言語モデルでは対話形式のテキストから出力の型を固定します。
画像生成のLoRAは、視覚的な一貫性を保つための強力な手段です。
言語モデルのLoRAは、回答の表現スタイルを統制するための手段として重宝します。
社内の問い合わせ対応を自動化したい場合は、AIカスタマーサポートの設計事例が参考になります。
ゲーム用の立ち絵や背景の制作を効率化するなら、AIゲーム制作のワークフローと組み合わせると便利です。
LoRA学習に必要なハードウェアと料金相場
LoRA学習を実行する環境には、手元のローカルPCと従量課金のクラウドGPUサービスの2つの選択肢があります。予算と学習頻度に合わせて最適な環境を選びます。
ローカルPCで学習する場合、NVIDIA製のGPUが不可欠です。
VRAM(ビデオメモリ)の容量が成否を分けます。
Stable Diffusionの標準的なLoRA学習であれば、最低でも12GBのVRAMが必要です。
最新の大規模画像モデルや8Bクラスの言語モデルを学習させるなら、16GBから24GBのVRAMを搭載したGPUが求められます。
GeForce RTX 4070 Ti(16GB)やRTX 4090(24GB)が有力な候補です。
初期投資として20万円から40万円前後のハードウェア費用がかかります。
頻繁に学習を回すユーザーにとっては、電気代以外の追加費用が発生しないため経済的です。
たまにしか学習しない場合や、初期費用を抑えたい場合はクラウドGPUが適しています。
RunPod、Lambda Labs、Vast.aiなどのGPUレンタルサービスを使えば、時間単位で必要なマシンを借りられます。詳しくはRunPod料金は1時間0.16ドルから。主要GPUの単価比較とコスト抑制策にまとめています。
1回あたりの学習時間は、設定やデータ量にもよりますが20分から1時間程度です。
RTX 4090搭載インスタンスなら1時間あたり約0.3ドルから0.5ドル。
業務用のA100(80GB)であっても1時間あたり1.2ドルから1.8ドル程度で利用できます。
主要なクラウドGPUサービスの料金目安を整理しました。
| サービス名 | 代表的な | 時間単価の | LoRA学習1回の |
|---|---|---|---|
| RunPod | RTX 4090 (24GB) | 約$0.34〜$0.45 / 時間 | 約$0.20〜$0.50 |
| RunPod | A100 (80GB PCIe) | 約$1.19〜$1.49 / 時間 | 約$0.80〜$1.50 |
| Lambda Labs | A10 (24GB) | 約$0.60〜$0.75 / 時間 | 約$0.40〜$0.80 |
| Vast.ai | RTX 3090 / 4090 | 約$0.25〜$0.40 / 時間 | 約$0.15〜$0.40 |
つまり、クラウド環境を使えば1コイン程度の小額でLoRAを1個作成できます。
自前の高額なPCを購入しなくても、手軽に実験を始められます。
API経由で学習を提供するマネージドサービス(Together AIやFireworksなど)も存在します。
こちらはGPUの管理が不要な反面、トークン量に応じた従量課金となり、DIY学習よりやや割高になります。
費用を最小限に抑えたいなら、RunPodなどのクラウドGPUを使った自作学習が圧倒的におすすめです。
自律的に学習スクリプトを回して作業を効率化したいときは、AIエージェントを併用すると設定の自動化が進みます。
失敗を防ぐLoRA学習の主要ハイパーパラメータ
LoRA学習を成功させるには、いくつかの主要な設定値を正しく調整する必要があります。不適切な値を設定すると、過学習によって画像が破綻したり、逆に学習不足で効果が出なかったりします。
最も重要なパラメータはランク($r$)とアルファ($\alpha$)の2つです。
ランク($r$)は、低ランク行列の幅を決定します。
値を大きくすると保持できる情報量が増えますが、ファイルサイズが大きくなり、過学習のリスクも上がります。
一般的なキャラクター学習であれば、16から32で十分です。
複雑な絵柄全体を学習させる場合でも、64程度が上限の目安となります。
アルファ($\alpha$)は、元のモデル出力に対してLoRAの重みをどの程度の強さで反映させるかを決めるスケール係数です。
通常、アルファの値はランクと同じ値か、ランクの半分に設定します。
たとえばランクを16にした場合、アルファは8または16を選びます。
学習率(Learning Rate)も出力品質を大きく左右します。
値が高すぎると学習が発散し、画像がグロテスクに崩れます。
値が低すぎると何千回ステップを回しても特徴が反映されません。
主要なパラメータの推奨設定値を表にまとめました。
| パラメータ名 | 役割 | 推奨設定値 | 設定時の |
|---|---|---|---|
| Network Rank ($r$) | 情報保持の次元数 | 16 〜 32 | 大きすぎると過学習の原因になる |
| Network Alpha ($\alpha$) | 反映強度のスケーリング | 8 〜 32 | 通常は$r$の0.5倍〜1倍に設定 |
| Learning Rate | パラメータの更新幅 | 1e-4 〜 5e-4 | テキストエンコーダー側は半分程度に下げる |
| Batch Size | 1ステップで処理する画像数 | 1 〜 4 | VRAM容量と相談して決定 |
つまり、初期設定に迷った場合はランク16、アルファ16、学習率0.0001から開始するのが安全です。
過学習が起きた場合は、学習率を下げるかエポック数を減らします。
逆に特徴の出方が弱いと感じた場合は、学習ステップ数を増やすかランクを32へ引き上げます。
最初から極端な数値を指定せず、標準的な設定から少しずつ動かすことが成功への近道です。
作業全体のスケジュールやデータ管理を整理したい場合は、AIプロジェクト管理のツールを導入すると進行が安定します。
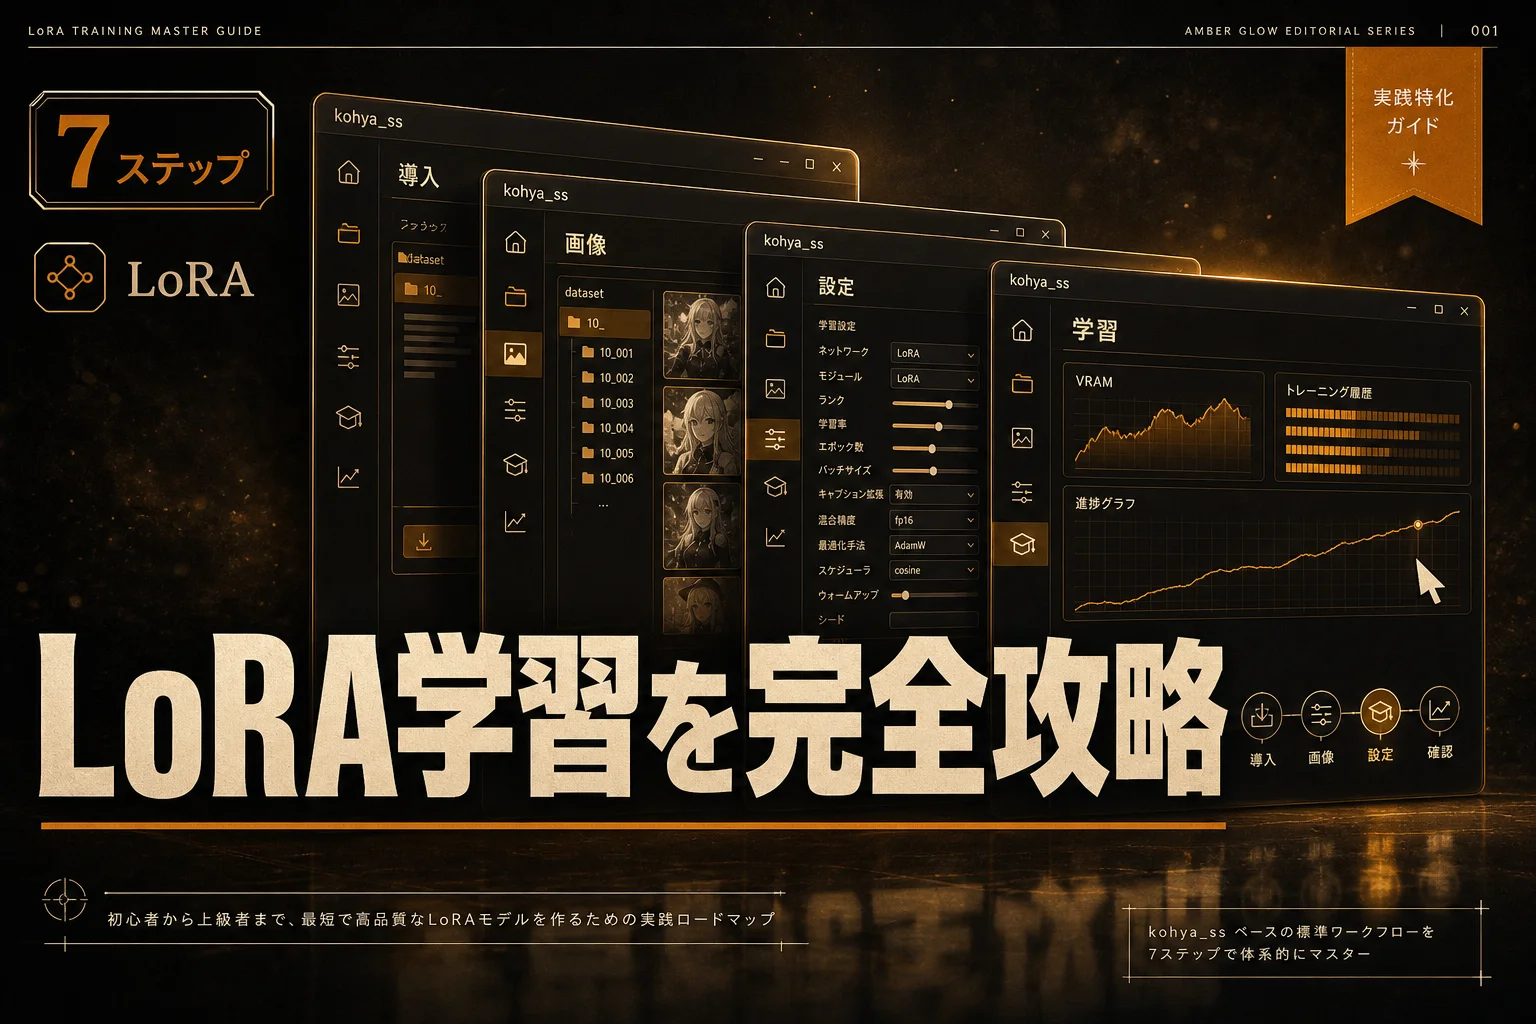
Kohya_ssを使った画像LoRA作成の具体的手順
画像生成モデルのLoRAを作成する現場では、Kohya_ss(sd-scriptsのGUIラッパー)が標準ツールとして定着しています。データセットの準備から学習実行までの具体的な流れを把握しておきます。
作業は大きく3つの段階に分かれます。
第1段階は画像データの収集とトリミングです。
キャラクターのLoRAを作る場合、15枚から25枚前後の画像を用意します。
全身、バストアップ、顔のアップなど、様々な構図をバランスよく集めます。
背景が単調な画像や、服装が異なる画像を含めると、特定のポーズや衣装への不要な固執を防げます。
解像度はベースモデルに合わせて正方形や適切な比率に揃えます。
第2段階はキャプション(タグ付け)の作成です。
各画像に対して、何が描かれているかを説明するテキストファイル(.txt)を用意します。
自動キャプション生成機能(WD14 Taggerなど)を使うと一瞬でタグが生成されます。
ここで重要なのが「トリガーワード」の設定です。詳しくはトリガーワードとは?LoRAや画像生成AIで狙い通りの出力を引き出す指定方法と3つの注意点にまとめています。
学習させたい固有の単語(例: my_character_name)をキャプションの先頭に必ず配置します。
髪色や目の色など、キャラクター固有の特徴タグをキャプションに残すか消すかで学習の挙動が変わります。
タグを消すと、その特徴がトリガーワードの中に強く焼き込まれます。
第3段階はKohya_ssでの学習設定と実行です。
データフォルダの構成を規定のルールに従って作成します。
フォルダ名に「リピート回数_トリガーワード」の形式を指定します(例: 10_mycharacter)。
GUI画面でベースモデルを選択し、先ほど確認したパラメータ(ランク16、アルファ16など)を入力します。
学習開始ボタンを押せば、自動的にトレーニングが進行します。
20分から40分程度で、出力フォルダに拡張子 .safetensors のファイルが生成されます。
完成したファイルを画像生成ツールのLoRAフォルダに配置し、プロンプトでトリガーワードを呼び出してテストします。
対話キャラクターのプロファイルや台詞設定も同時に作り込みたいなら、AIキャラチャットのノウハウを組み合わせると表現の幅が広がります。
QLoRAとの違いとメモリを節約する先端派生技術
LoRAの登場以降、さらにメモリ消費を削るための派生技術が次々と開発されています。代表格が4bit量子化を組み合わせたQLoRAです。
QLoRA(Quantized Low-Rank Adaptation)は、ベースモデルの重みを4bitに圧縮してGPUに読み込み、その上でLoRAの学習を行う技術です。
通常の16bit浮動小数点数(FP16)で読み込む場合に比べ、ベースモデルのメモリフットプリントをほぼ4分の1に削減します。
これまで24GB以上のVRAMが必要だった13Bクラスのモデルが、12GB前後の民生用GPUでも学習可能になりました。
QLoRAを実現するために、3つの主要な技術が導入されています。
第1に、正規分布に従う重みに最適化された4bit NormalFloat(NF4)というデータ形式です。
第2に、量子化定数自体をさらに量子化してメモリを削る二重量子化(Double Quantization)です。
第3に、VRAMが不足した際に一時的にメインメモリへ退避させるページド・オプティマイザ(Paged Optimizers)です。
これらの技術により、性能低下をほぼゼロに抑えながら必要メモリを大幅に圧縮しています。
代表的なLoRA派生技術の特徴を整理しました。
| 技術名 | 特徴 | 主な | 適した |
|---|---|---|---|
| LoRA | 基本となる低ランク適応技術 | 安定性が高くツールが豊富 | 画像・テキストの標準的な学習 |
| QLoRA | 4bit量子化とLoRAの融合 | 必要VRAMを極限まで低減 | 中〜大規模LLMの手元学習 |
| DoRA | 大きさと方向を分離して学習 | フル学習に近い高い表現力 | 微細な画風や高度な推論の調整 |
| LoCon / LoHa | 畳み込み層へ適応を拡大 | 広範囲な特徴抽出が可能 | 画像生成の背景や全体の絵柄 |
つまり、使用するモデルの規模やGPUのスペックに応じて最適な派生技術を選択します。
大規模な言語モデルを限られたリソースで動かすならQLoRAが一択です。
画像生成においてより精緻な画風を再現したいなら、DoRA(Weight-Decomposed Low-Rank Adaptation)の採用が有力な選択肢となります。
日常の業務フロー全体を自動化したい場合は、AI自動化のツール群を組み合わせることで運用の手間を削れます。
個別の業務タスクの生産性を底上げしたいときは、AI生産性の活用法も押さえておくと無駄が省けます。
AI PICKS編集部の判定
LoRAは、AIの追加学習にかかるコスト構造を根本から塗り替えた画期的な技術です。個人開発者から中小企業まで、独自のAIモデルを実用化するならLoRAが一択です。
かつて数千万円規模の計算資源を要したモデル調整が、今や1回あたり数百円のクラウドGPU費用で完結します。このコストパフォーマンスは破格です。完成したLoRAファイルが数十MBから百数十MBと非常に軽量で、本体モデルを汚さずに脱着できる取り回しの良さも重宝します。
一方で、過度な期待は禁物です。LoRAは既存モデルが持つ潜在的な能力を引き出す調整手法であり、まったく未知の高度な推論能力をゼロから植え付ける用途には正直イマイチです。ベースモデル自体の基礎体力が足りない場合、どれほどパラメータをいじっても求める出力は得られません。
画像生成でのキャラクター固定や、LLMにおける社内フォーマットの統一といった明確な目的があるなら、圧倒的な効果を発揮します。まずは手元の安価なクラウドGPUで小さなデータセットから試してみるのが、最も堅実で無駄のない始め方です。
よくある質問(FAQ)
Q. LoRAの学習には何枚の画像が必要ですか?
キャラクターや特定の人物を固定する場合、15枚から30枚程度が標準的な枚数です。構図やアングルが異なる高品質な画像を用意することが、枚数の多さよりも重要です。全体の画風や背景スタイルを学習させる場合は、50枚から100枚程度を用意すると安定した結果を得られます。
Q. LoRAとRAG(検索拡張生成)は何が違いますか?
LoRAはモデルの出力トーンや回答の形式といった「振る舞い」を微調整する技術です。RAGは社内マニュアルなどの最新文書を外部から検索して読ませる「カンニングペーパー」の仕組みです。社内の最新情報や正確な事実を答えさせたいならRAGが適しており、特定の口調や業界特有の言い回しを定着させたいならLoRAが適しています。
Q. パソコンにGPUがなくてもLoRAは作れますか?
ローカルPCにNVIDIA製GPUがなくても問題ありません。RunPodやVast.aiといったクラウドGPUサービスを利用すれば、ブラウザ経由で数十分の作業として学習を実行できます。費用も1回あたり数十セントから数ドル程度で済むため、高価なパソコンを購入する前にクラウド環境を試す方法をおすすめします。
Q. 複数のLoRAを同時に重ねて使うことはできますか?
同時に適用できます。画像生成ツールでは、キャラクターLoRAと衣装LoRA、画風LoRAを同時に読み込み、それぞれの適用度(ウェイト)を0.5や0.7のように調整して合成できます。ただし、重ねすぎると画像が破綻しやすくなるため、同時に使用するのは2個から3個程度にとどめるのが無難です。
次に読むならこれ: 生成画像のバリエーションをさらに広げたい方は、AI画像生成ツールの機能比較を確認しておくと、制作パイプライン全体の効率を一段引き上げられます。