ElevenLabs、MCPで音声・音楽・画像・動画の生成に対応 「ChatGPT」などから50超のモデル
- ElevenLabsのMCPで音声・音楽・画像・動画を生成できるようになりました。
- 「ChatGPT」「Claude」「Cursor」「Grok Bot」「Hermes」で使えます。
- 1回つなぐだけで50を超える画像・動画モデルを呼び出せます。
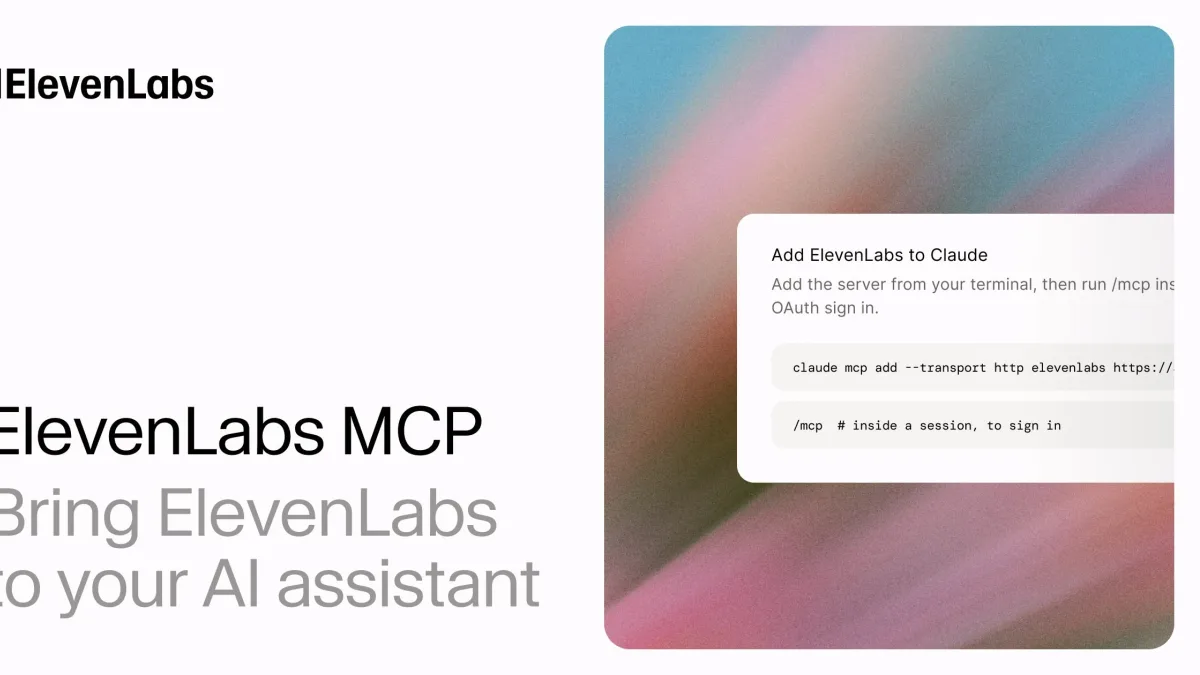
ElevenLabsは、同社のMCP (AIアシスタントに外部サービスをつなぐ規格) で音声・音楽・画像・動画を生成できるようにしました。すでに「ChatGPT」「Claude」「Cursor」「Grok Bot」「Hermes」で利用できます。
つなぐのは1回だけで、同社の音声モデル、文字起こしの「Scribe」、吹き替え、音楽、効果音、そして50を超える画像・動画モデルが使えるようになります。会話の中でライブラリの声を指定してナレーションを頼むと、その場で音声が返ります。別の言語で頼めば、同じ接続を通って吹き替えまで仕上がります。
「Scribe」は録音データを渡すと整った書き起こしを返します。台本や字幕、吹き替えにそのまま回せます。画像は生成してから編集し、動画に動かし、口の動きを合わせるところまで同じ接続で進みます。
生成したものはすべてElevenCreativeのワークスペースに残ります。Studioで開いて時間軸を調整し、ナレーションを整え、音楽や効果音を重ねて書き出せます。接続はOAuthのサインインが1回だけで済み、APIキーは不要で、いつでも取り消せます。
1つの依頼から台本、ナレーション、音楽、効果音、動画までをまとめて作れます。ElevenLabs Agentsを動かしているMCPと同じもので、1回の導入で両方をまかなえます。
つまり、いつも使っているAIチャットに、音と映像を作る道具箱をまるごと足せるということです。これまでは音声を作るサイトを開き、動画のサービスに移り、編集ソフトで組み立てる、という行き来が必要でした。今回はその行き来が要らなくなり、チャット欄に「この台本でナレーションを、別の言語版も」と頼めば形になって返ってきます。作ったものは自分のワークスペースに残るので、後から音楽を足したり声を差し替えたりもできます。
窓口は1つ。音声も音楽も画像も動画も、同じ接続から出てきます。
発表を読んで引っかかったのは、50を超える画像・動画モデルを束ねてきたところです。ElevenLabsは音声の会社という印象が強かったので、映像側まで抱え込む構えは意外でした。どのモデルを使うかをアシスタント側に任せる作りなので、今いちばん良いものを自分で追いかけなくて済むぶん、使う側はかなり楽になるはずです。
そういえば、APIキーを配らずサインイン1回で済み、いつでも取り消せる点は法人で重宝しそうです。試したい部署に権限を渡し、合わなければ止められます。
気になるのは日本語です。ナレーションと吹き替え、それに「Scribe」の書き起こしがどこまで通用するか。同じ接続で動く「ElevenLabs Agents」の日本語対応がどこまで乗ってくるかも、次に見ておきたい点です。
動画やナレーションの制作を社外に出している人は、「ChatGPT」や「Claude」の会話の中で台本から音声、音楽、動画までを続けて作れるようになります。
出典: ElevenLabs ↗